Score-based Generative Models
Score-Based Generative Models
A representative reference: Yang Song blog
Generative Modeling by Estimating Gradients of the Data Distribution, 2019, Neurips, 1825 citation Score-based generative modeling through stochastic differential equations, 2020, arXiv, 2238 citation
Core Idea
Generative Modeling by Estimating Gradients of the Data Distribution, 2019, Neurips, 1825 citation
Intro
- 존재하는 생성 모델은 확률 분포를 표현하는 방법에 따라 두 category 로 분류할 수 있다.
- Likelihood-based models
- 분포의 PDF/PMF 를 (approximate) maximum likelihood 를 통해 직접적으로 학습한다.
- Bayes's Theorem 정리
- E.g.,
- Autoregressive models (PixelRNN, etc.)
- Normalizing flow models
- Energy-based models (EBMs)
- VAE:
- Bayes rule 로 표현한 값의 사후 확률까지 approximation 하고자 했다.
- ELBO trick 으로 확률 분포를 근사한다.
- Implicit generative models
- 확률 분포를 sampling process 로 암시적으로 나타낸다.
- E.g.,
- GAN: 확률 분포를 직접 근사하지는 않고, 다른 loss 를 이용한다. 이때 이 loss 를 푸는 과정이 암시적으로는 확률 분포를 푸는 문제와 동일하다고 볼 수 있다. 즉, 간접적으로 푸는 형태.
- Generator: \(p(x) = \int_z{p(x|z)p(z)dz}\) , implicit PDF 학습
- GAN 은 위의 수식이 intractable 하므로, Monte Carlo 로 근사한다.
- 실제로 loss 는 위와 다르지만 implicit 하게 maximize.
- GAN: 확률 분포를 직접 근사하지는 않고, 다른 loss 를 이용한다. 이때 이 loss 를 푸는 과정이 암시적으로는 확률 분포를 푸는 문제와 동일하다고 볼 수 있다. 즉, 간접적으로 푸는 형태.
- Likelihood-based models
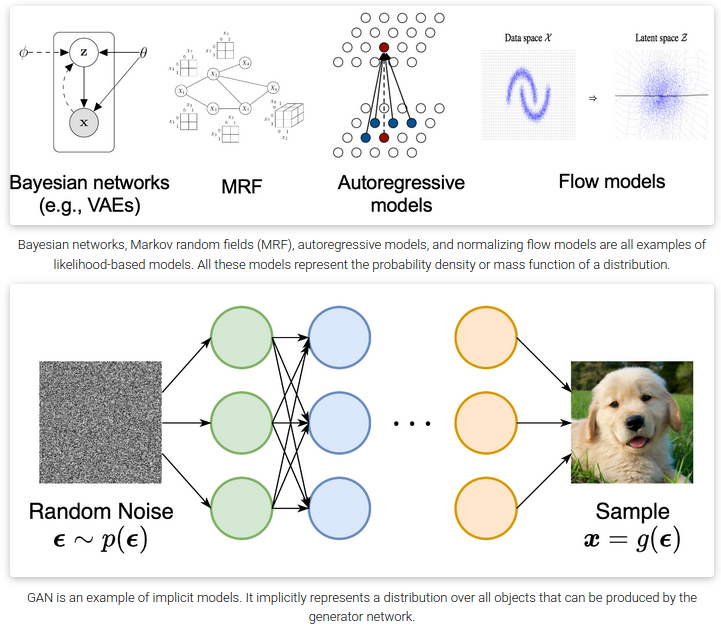
- 하지만, 이 두 가지 방법론은 significant limitation 이 존재한다.
- Likelihood-based models
- Tractable normalizing constant 를 보장해야 해서 model 구조의 강력한 제한이 있거나
- E.g., invertible networks in normalizing flow models
- Approximate the normalizing constant: 계산 비용이 많이 든다.
- E.g., energy-based model
- Maximum likelihood 를 근사하는 objective 로 설정. 정확한 계산이 아니다.
- E.g., ELBO of VAE
- Sampling speed 가 느리다.
- E.g., Autoregressive models
- Tractable normalizing constant 를 보장해야 해서 model 구조의 강력한 제한이 있거나
- Implicit generative models
- Adversarial training: unstable, mode collapse
- Likelihood-based models
Mode collapse: generator 가 다양한 이미지를 만들어내지 못하고, 비슷한 이미지를 생성하는 경우를 말한다.
MNIST 를 예를 들면, mode 는 총 0-9까지 10개이고, generator 는 random noise 를 입력으로 받아서 생성한 이미지가 discriminator 를 속이기를 원한다. 이때, 0-9 의 다양한 mode 를 이용하지 않고 하나의 mode 만 생성하는 것.
- 본 review 에선, 이런 제한을 우회하면서 확률 분포를 표현하는 다른 방법을 소개한다.
- Normalizing constant 가 tractable 하지 않아도 된다.
- Score matching 을 통해, 확률 분포를 직접 배운다.
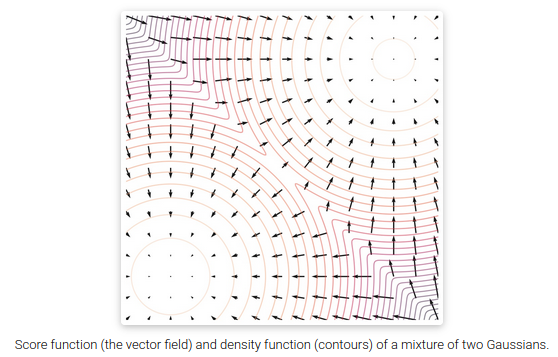
score fucntion 은 분포가 밀집되어 있는 방향을 가리킨다. 다시 말해, score function 이 증가하는 방향으로 sampling 을 하면 된다!
Method
Process: learn score matching -> Langevin dynamics sampling
-
\(\Vert \Vert_2^2\) : 유클리드 norm 의 제곱 (\(x^2 + y^2 + \cdots\))
-
\(\Vert \Vert_2\) : 우리가 아는 거리 공식 (유클리드안 거리) 이자 \(L_2\) norm
Score fucntion
- Dataset \(\{x_1,x_2, \cdots, x_N\}\) 이 주어졌을 때, model 이 \(p(x)\) 를 배우기를 원한다.
- \(p(x)\) 를 먼저 표현할 줄 알아야 model 을 통해 근사시킬 수 있다.
\(f_\theta(x)\) 는 unnormalized probabilistic model or energy-based model 이라고 부른다.
- 따라서, maximizing log-likelihood of the data 를 통해 \(p_\theta(x)\) 를 학습할 수 있다.
- 하지만, log-likelihood 를 maximize 하기 위해선 \(p_\theta(x)\) 가 정규화된 PDF(normalized probability density function)여야 한다. 이건 계산상의 어려움을 일으키는데, 우리는 일반적인 \(\theta\) 에 대해 일반적으로 복잡한 양인 정규화 상수 \(Z_\theta\) 를 계산해야 하기 때문이다.
- 따라서, maximum likelihood 를 가능하게 하려면 likelihood-based model 은 모델 구조를 제한하거나 정규화 상수를 다루기 쉽게 만들기 위해 정규화 상수를 근사해야 했다.
- Density function 대신 Score function 을 modeling 함으로써, 우리는 intractable normalizing constant 의 어려움을 피할 수 있다.
Score function 에 대한 model 을 Score-based model 이라고 부른다.
- Score-based model \(s_\theta(x)\) 는 Score fucntion 을 학습한다.
- \(s_\theta(x)\) 가 normalizing constant \(Z_\theta\) 에 독립적이라는 것에 주목해야 한다.
- Normalizing constant tractable 을 보장하기 위해 특별한 모델 구조를 설계할 필요가 없다.
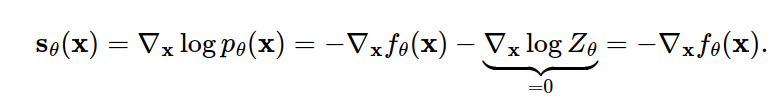
- 즉 loss 는 다음과 같이 정의된다. using Fisher divergence.
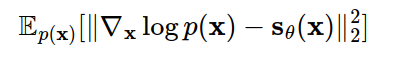
- 직접적으로 divergence 를 계산하려고 했지만, \(\nabla_x \log{p(x)}\) 를 알지 못한다.
- 다행히, score matching method 를 통해 ground-truth data score 를 몰라도 Fisher divergence 를 minimize 할 수 있다.
Score matching
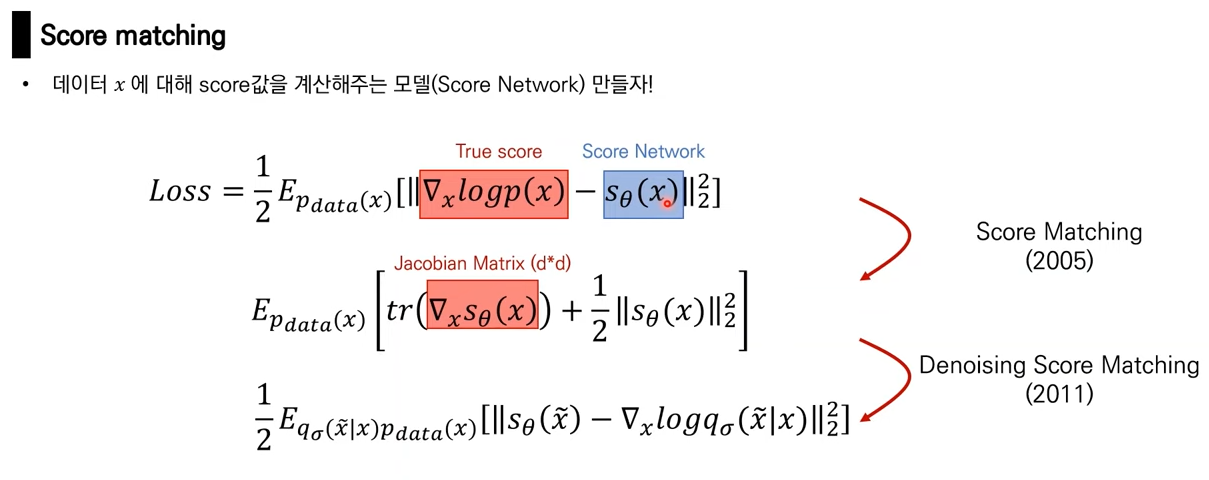
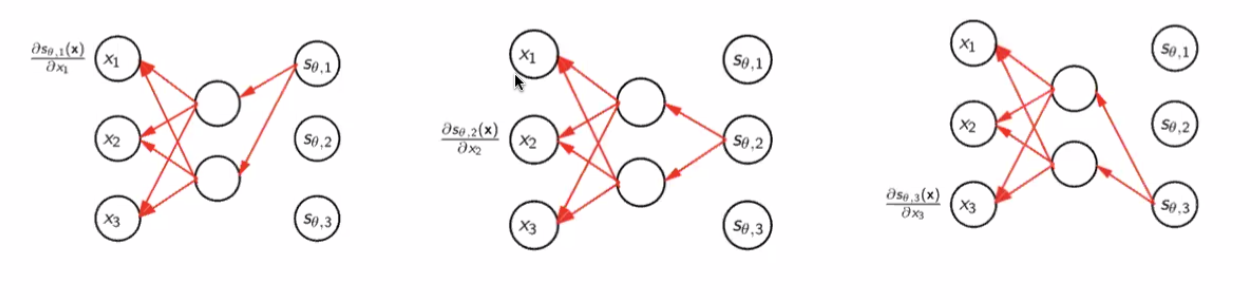
- Score matching 을 이용하여 loss 를 바꿔주면, real log distribution 을 몰라도 된다. 하지만 여러 번의 backpropagation 을 해야해서 계산량이 많다.
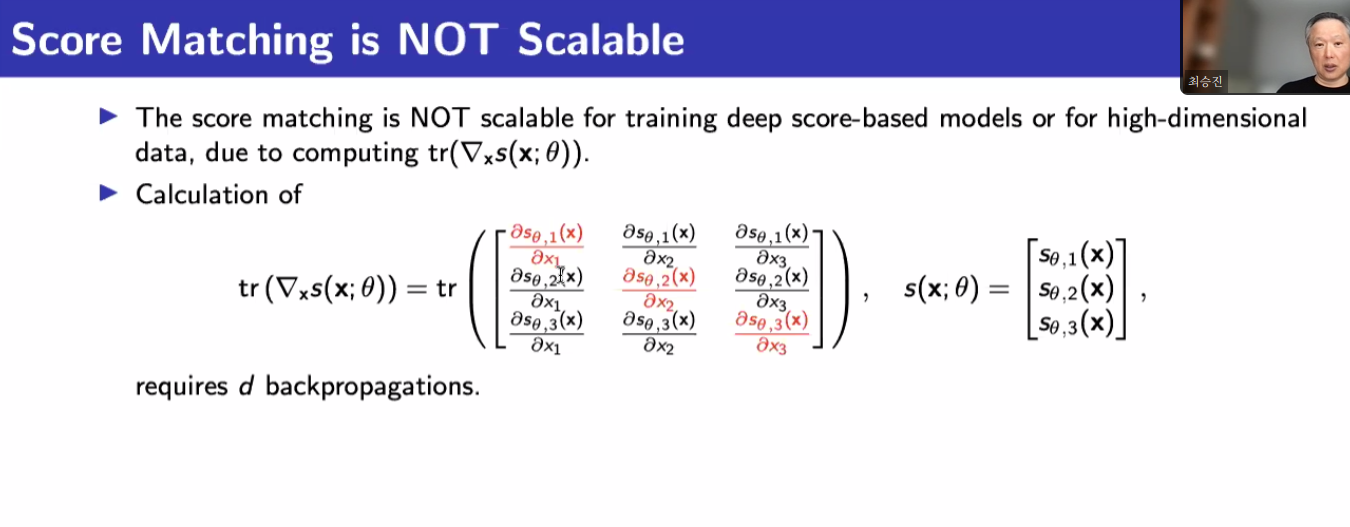
- Score network 의 Jacobian trace 를 구해야 된다.
- Data 가 image 이고 그 dim 이 \(300 \times 300\) 이라면 \(90,000\) dimension 을 갖는다.
- 따라서 score 의 dimension 도 \(90,000\) 을 가지고
- 거기에서 Jacobian trace 를 구하는 건 \(90,000 \times 90,000\) 을 dimension 을 가지게 된다.
- 즉, 계산량이 많다.
- 따라서 scalable 하지 않다.
- Score Matching 의 직관적인 이해: 우리의 목적은 다음의 loss function 을 minimize 하는 것이다.
- 첫 번째 텀 (Trace) 은 \(-inf\) 로 가야하는데 score fucntion 에 한 번 더 미분한 값이니 (\(p(x)\) 를 \(2\) 번 미분) \(p(x)\) 의 local maxima 를 의미한다.
- 두 번째 텀 (제곱 텀) 은 score function 이므로 분포의 꼭대기에 도달했다면 당연하게도 \(0\) 의 값을 가져야 한다.
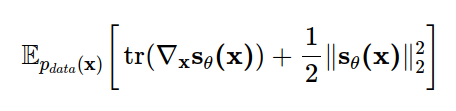
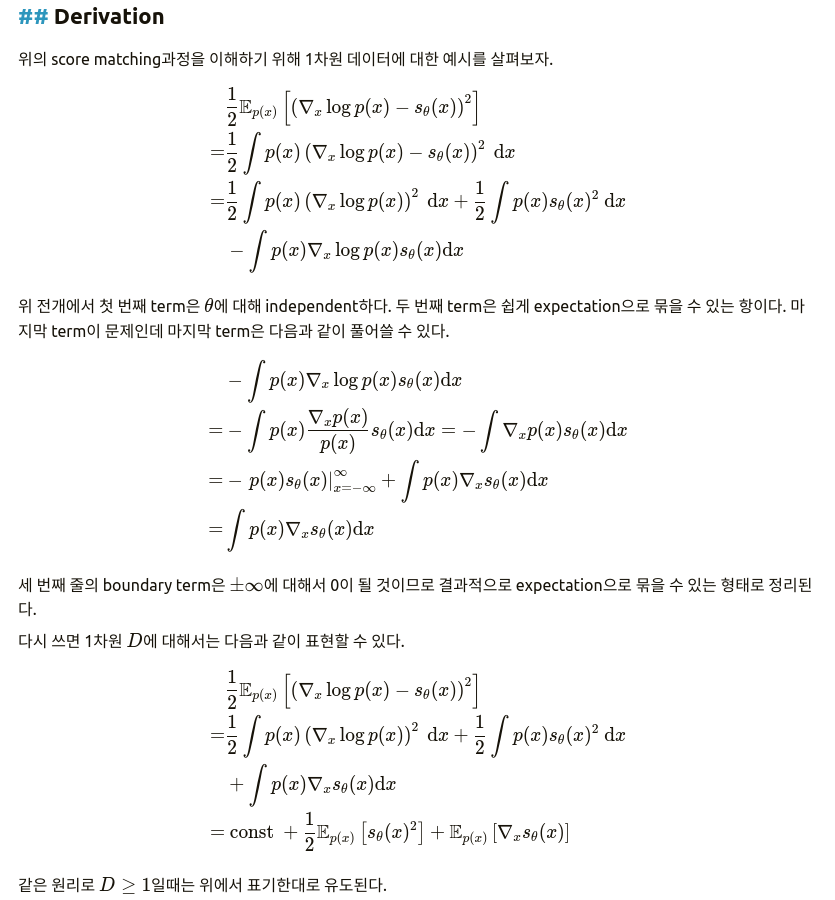
- Score Matching 증명
- Expectation 을 적분으로 풀어서 쓴다.
- 제곱을 풀어쓴다.
- \(\theta\) 와 관련 없는 항은 지운다.
- 마지막 항이 문제인데, 부분 적분으로 풀어서 쓰면 앞의 텀이 \(-inf / inf\) 일때, sampling 될 확률 값을 \(0\) 으로 가정하여 소거한다. (실제로 그 범위에 있을 확률은 매우 적으니까)
Trace: 주대각선 성분들의 합
Sampling: Langevin dynamics
Langevin dynamics:
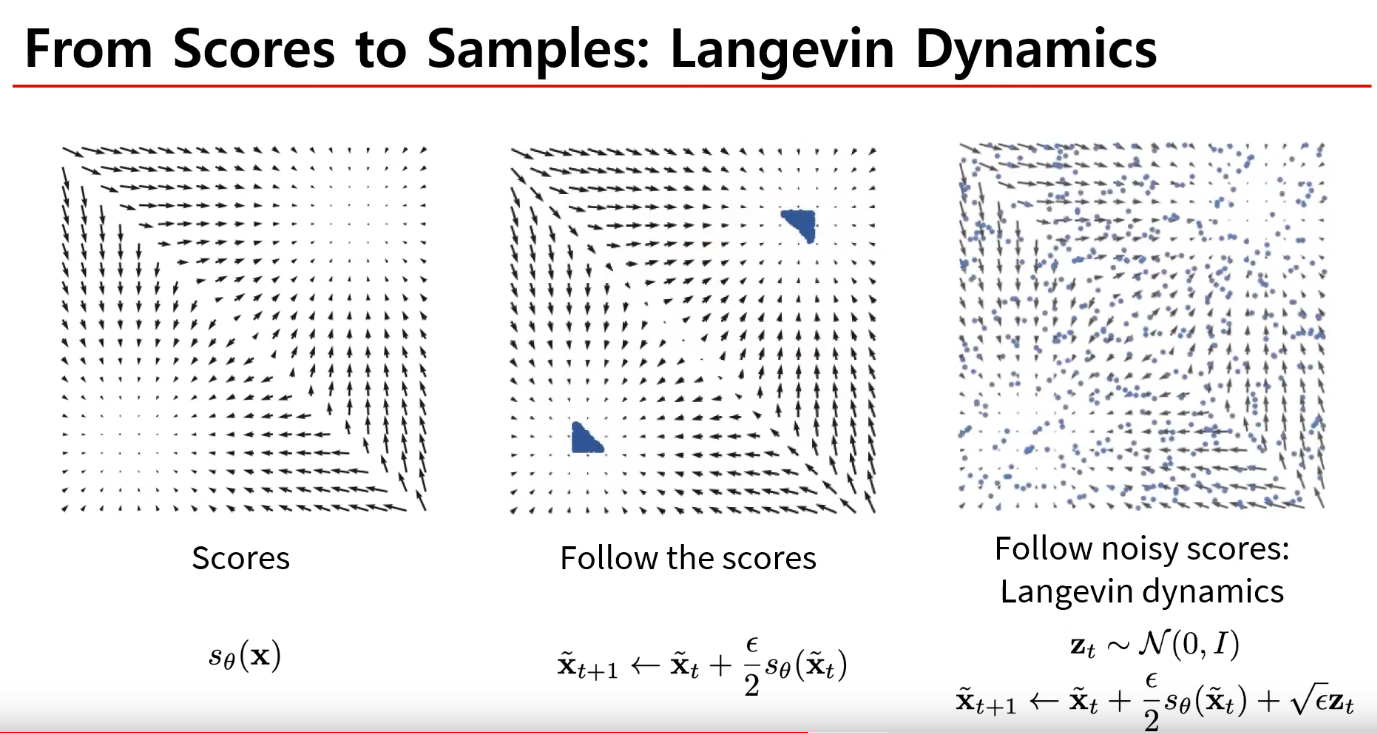
- Score-based model \(s_\theta(x) \approx \nabla_x \log{p(x)}\) 을 학습했으면, Langevin dynamics 라고 불리는 iterative procedure 을 통해 sampling 을 하면 된다.
- Langevin dynamics 는 오직 score function \(\nabla_x \log{p(x)}\) 만을 사용해, \(p(x)\) 로부터 MCMC procedure 를 제공한다.
- 구체적으로, 이 방법은 arbitrary prior distribution \(x_0 \sim \pi(x)\) 에서 다음을 반복한다.
- \(\epsilon\) > 0: step size
- 마지막 term 은 일종의 perturbation 을 추가하여 deterministic 한 local maxima 에 빠지지 않게 도와주는 역할이다.
- Thus, sampling 시 score 방향으로 가되 local maxima 에 빠져나가려고 perturbation 을 추가했다. 즉, sampling 의 개선
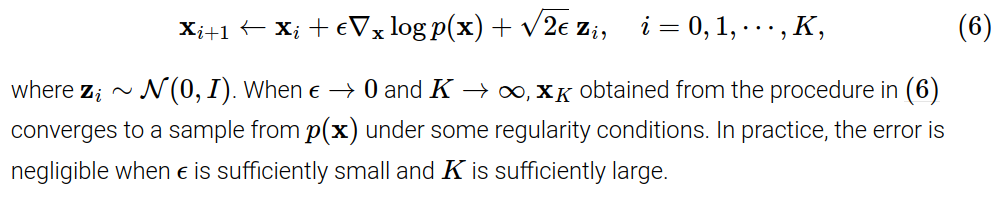
Denoising Score Matching with Langevin Dynamics (SMLD)
- 'Score matching 이 정확한 score 를 계산하는 식이지만 scalable 하지는 않다' 라는 점에서 출발했다. 즉, advanced score matching 을 제안.
- Noisy 한 data 간의 score matching 을 학습한다.
- Noisy 하기 때문에 clean data 의 score matching 과 정확하지는 않지만, 그 noise 가 충분히 작으면 원래 데이터의 score 를 예측 가능하다는 점에서 효과적이다.
- Denoising score matching 을 통해 얻고자 한 점은, scalable 하면서도 computation cost 가 비싸지 않은 loss 를 구하고자 하는 것이다.
- 하지만, 정확한 data distribution 의 score 를 계산하지는 못한다. 즉 noise 가 낀 data 의 distribution 을 계산하는 것
- Thus, 학습 데이터에 약간의 noise 를 추가하여 loss function 을 내가 표현할 수 있는 값들로 바꾸면서 동시에 scalability 를 챙겼다. 즉, loss 의 개선
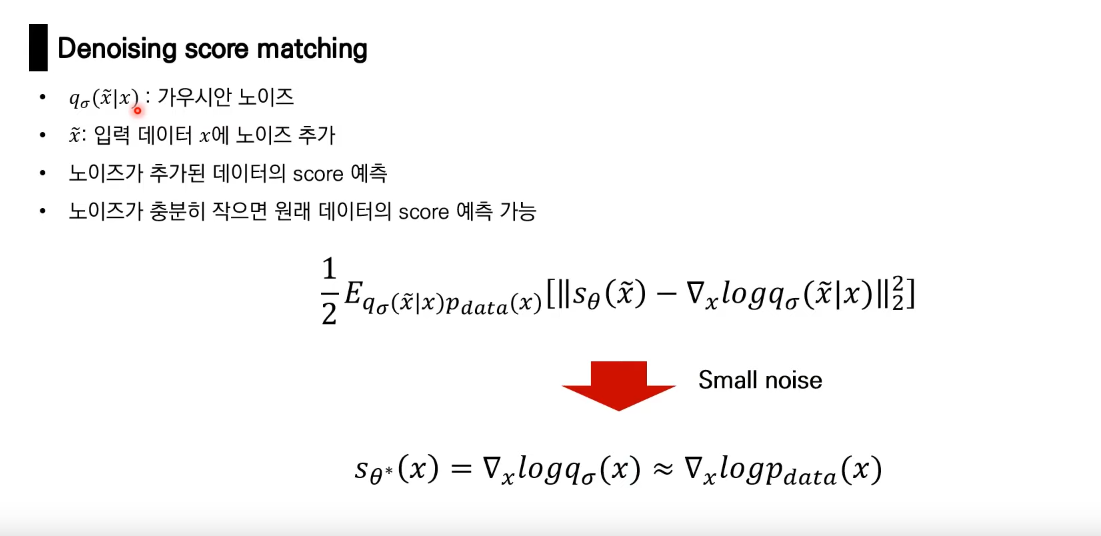
- \(\log{q_{\sigma}(\tilde{x}|x)}\) : \(x\) 를 조건으로 \(\tilde{x}\) 가 일어날 확률을 우리가 정의한다. (여기서는 multivariate Gaussian distribution)
- \(q_{\sigma}(\tilde{x})\) 는 \(q_{\sigma}(\tilde{x}|x)\) 를 \(x\) 에 대해서 marginalize 해서 구할 수 있다.
Proof via 6, 12p in Technical Report (Pascal Vincent)
-
먼저 \(x\) 와 \(\tilde{x}\) 는 \(q_{\sigma}(\tilde{x}|x)p_{data}(x)\) 의 분포에서 sampling (\(x\) 를 뽑고 그 조건하에서 noise 를 더해 \(\tilde{x}\) 를 뽑는다) 한다. 이때, \(q_{\sigma}(\tilde{x}|x)p_{data}(x) = q_{\sigma}(x,\tilde{x})\) 이므로 joint density probability 이다. 즉, \(x,\tilde{x} \sim q_{\sigma}(x,\tilde{x})\) 임을 기억하면 된다. (조건부 확률은 시간축이랑은 관계가 없다는 걸 유의하면 joint 로 바뀌는 걸 이해할 수 있다)
-
그런 다음, 우리가 원하는 objective function 을 다시 보자.
- 제곱을 풀어쓴다. \(C_2\) 는 \(\theta\) 에 관한 함수가 아니기 때문에 이 목적 함수에서는 상수 취급이다.
- 이때, \(\eta(\theta)\) 는 다음과 같다.
- 적분으로 풀면
- \(\log\) 미분
- 약분
- \(q_{\sigma}(\tilde{x}) = \int q_{\sigma}(\tilde{x}|x) p_{data}(x)dx\)
- \(\nabla_{\tilde{x}}\) 를 \(x\) 에 대한 적분 안으로 집어 넣는다. (\(x\) 에 대해서 적분이니까 가능)
- \(\log\) 미분을 역으로 이용 (score function trick)
- \(S_{\theta}(\tilde{x})\) 는 \(x\) 와 관련이 없으니, 마찬가지로 적분 안에 넣을 수 있다.
- \(q_{\sigma}(\tilde{x}|x)p_{data}(x) = q_{\sigma}(x,\tilde{x})\)
- \(\eta(\theta)\) 가 결합 확률 분포의 기댓값으로 표현이 된다.
- 다시 obejctive function 을 보면,
- 그리고 우리가 구하고자 하는 건 다음과 같다. (우리가 표현할 수 있는 값들로만 이루어져 있으니)
- 기댓값의 아래 첨자가 바뀐 이유는 목적 함수에서 \(x\) 라는 확률 변수도 추가됐기 때문이다.
- 우리가 구하고자 하는 목적 함수를 마찬가지로 제곱을 풀어써보면, 처음의 목적 함수와 \(\theta\) 입장에서 같다는 걸 알 수 있다.
- 첫 번째 항의 기댓값의 아래 첨자가 바뀐 이유는 역시나, 첫 번째 항에 \(x\) 가 없기 때문이다.
- \(+C_2 - C_3\) 를 하면 동일하다.
- 따라서, 우리는 목적 함수를 다음과 같이 바꿀 수 있게 된다.
- For a Gaussian perturbation kernel
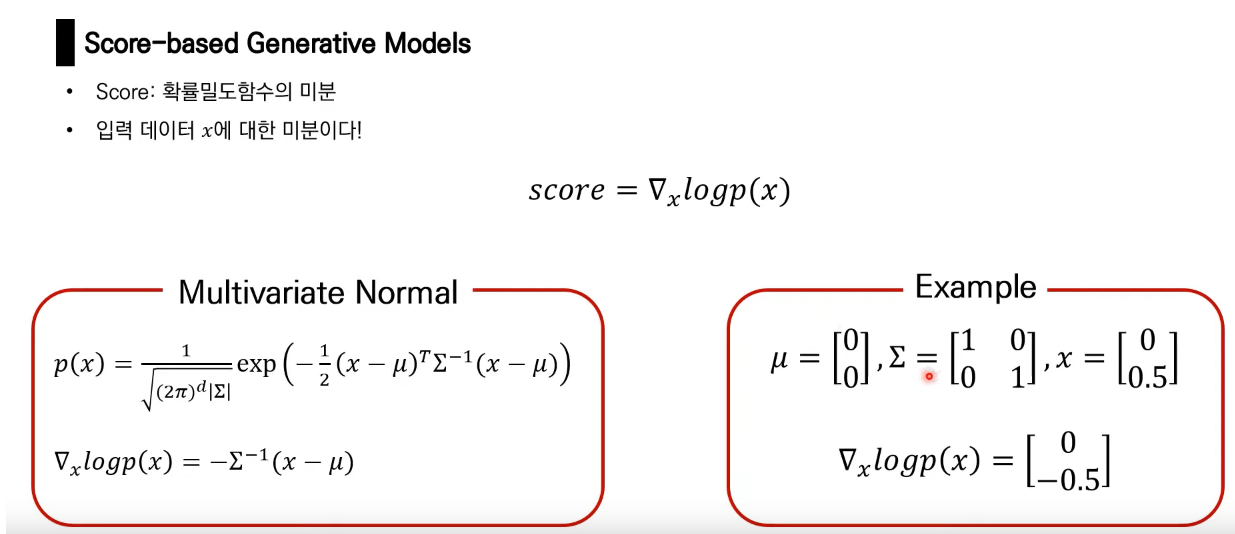
- Loss 를 보면 \(\tilde{x} -x = noise\) 로 볼 수 있는데, 결국 noise 를 맞추는 objective 즉, DDPM 에서의 목적과 유사하다.
- Noise scale \(\sigma\) 가 들어갔기에 아래첨자로 표시해줬다.
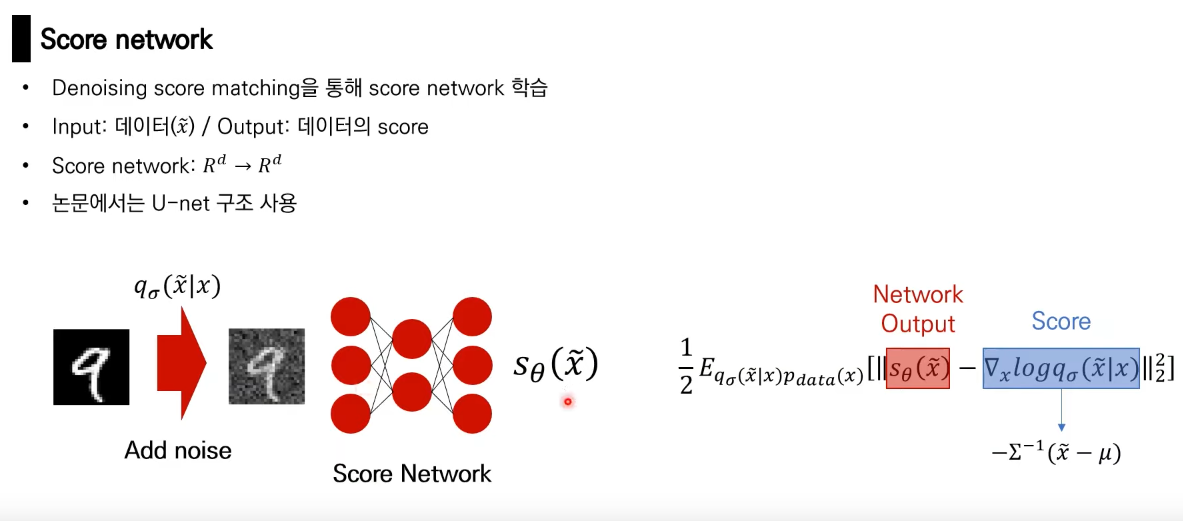
- Sampling 은 마찬가지로 Langevin dynamics 를 사용한다.
Problem in Low Density Regions (Inaccurate score estimation)
- 지금까지는 score matching 을 사용하여, score-based model 을 훈련하고 Langevin dynamics 를 통해 sampling 을 하는 방법을 살펴봤다. 그러나 이러한 단순한 접근 방식은 실제로는 제한된 성공을 거뒀다.
- 이제는 score matching 의 몇 가지 문제들에 대해 얘기를 해본다.
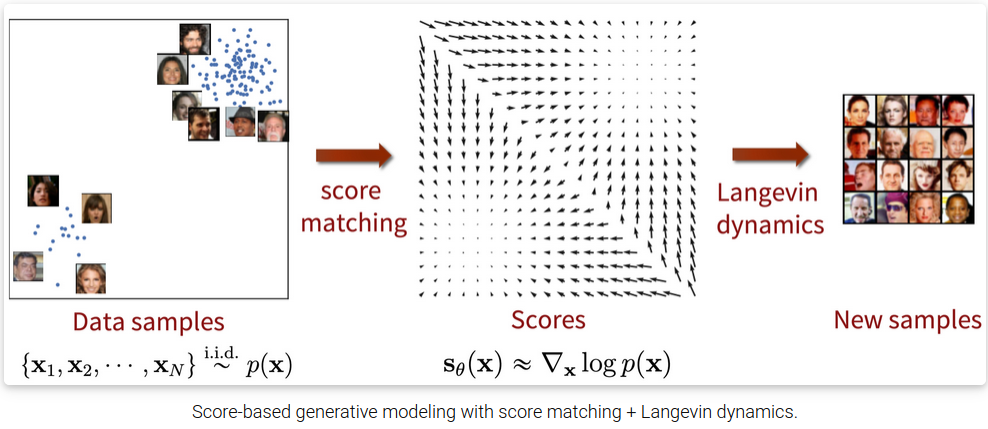
- 주요 문제는 적은 데이터 포인트가 존재하는 낮은 밀도 영역에서의 학습은 불완전하기 때문에 추정된 score function 이 부정확하다는 사실이다. 이는 score matching 이 Fisher divergence 를 최소화하도록 설계되었기 때문에 예상된 결과라고 볼 수 있다.
- Langevin dynamics 로 sampling process 를 시작할 때, 초기 sample 은 높은 확률로 low density region 에 위치한다. 따라서 부정확한 score-based model 로 인해, sampling 이 올바른 방향으로 진행되지 않는다.
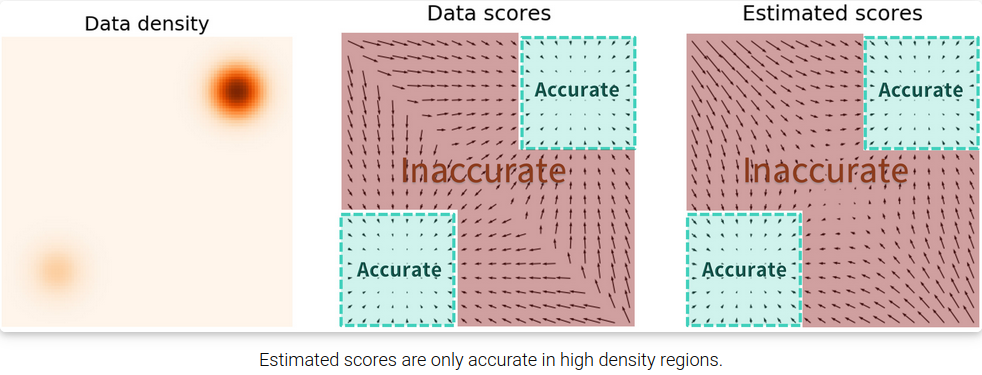
- 마찬가지로, 낮은 밀도 영역으로 인해 발생하는 문제이다.
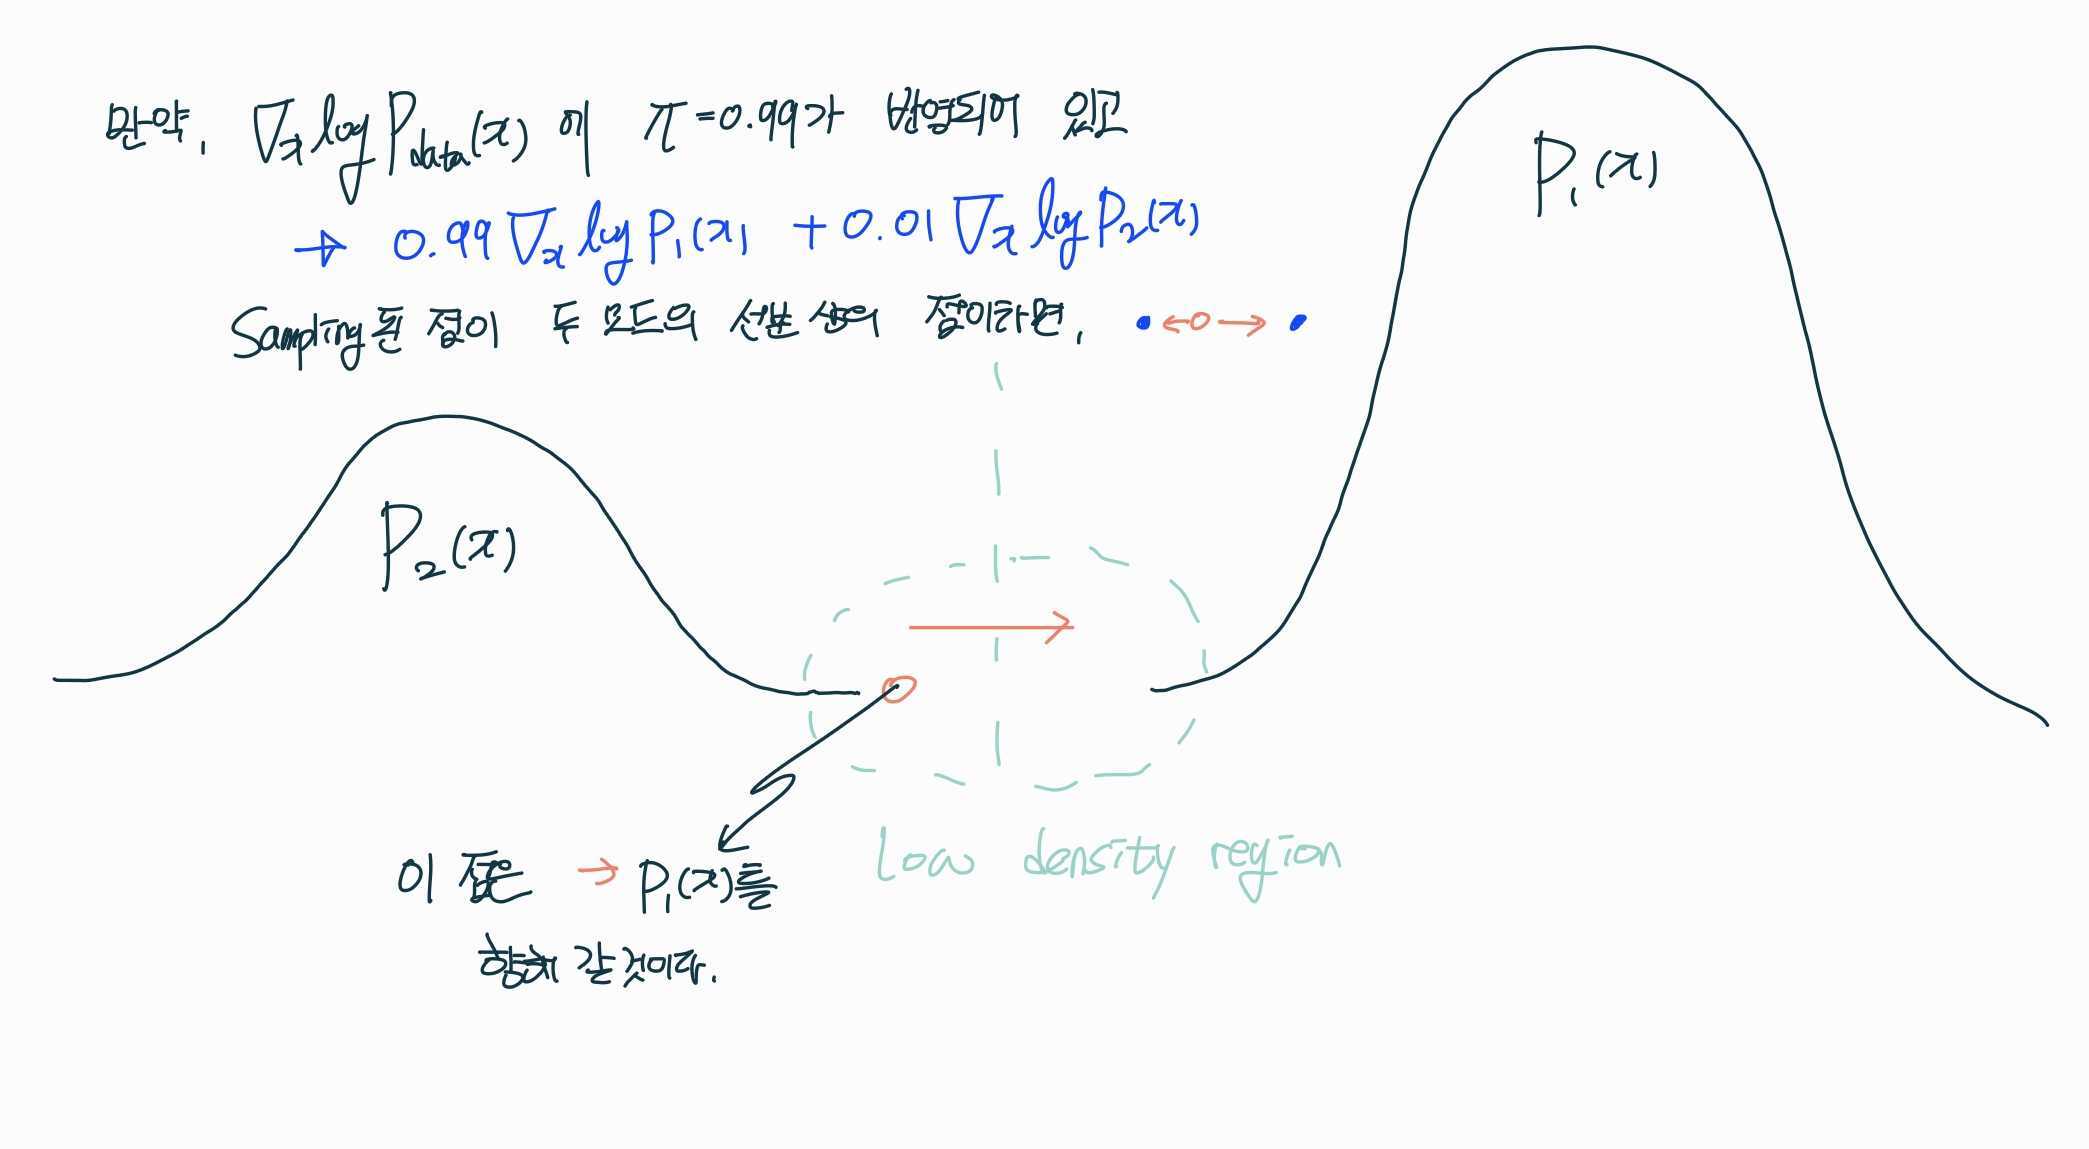
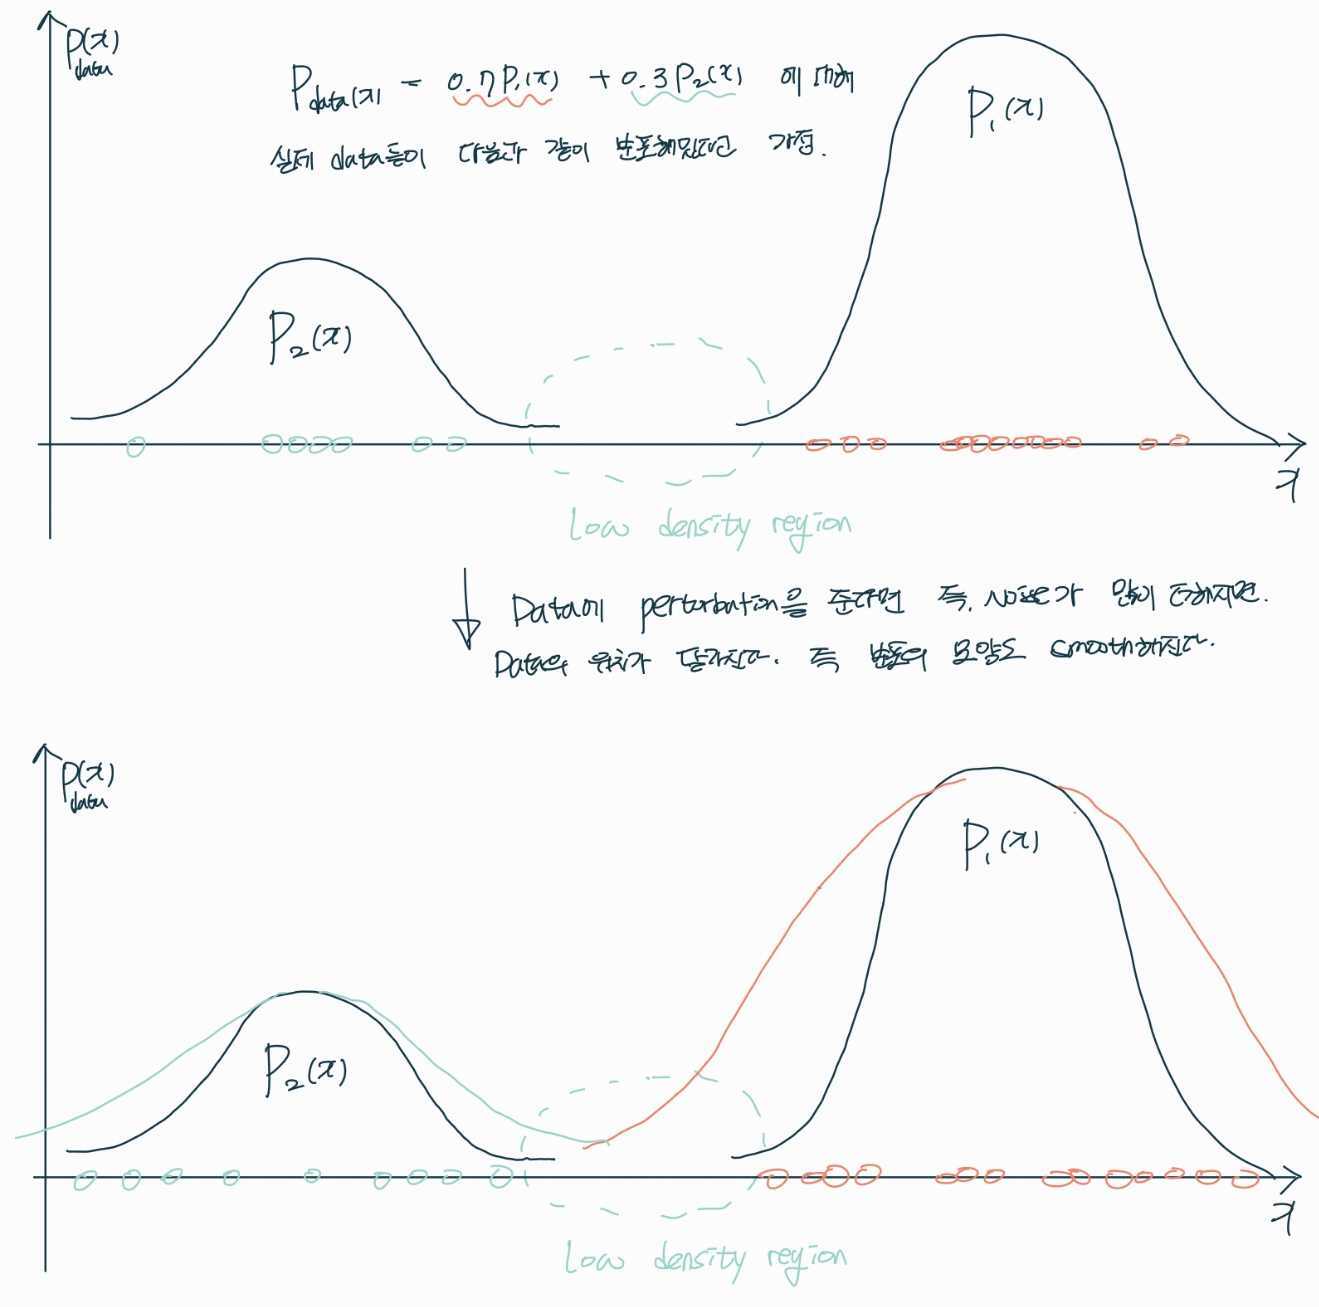
- \(2\) 개의 mode 로 구성된 mixture data distribution 을 가정. 두 모드는 낮은 밀도 영역으로 분리되어 있다고 가정. 즉, 두 모드가 엄청 멀리 있다고 생각해보자.
- \(p_{data}(x) = \pi p_1(x) + (1-\pi)p_2(x)\)
- \(\nabla_x \log\) 를 씌워보면, \(\pi\) 와 관련된 항들은 사라진다.
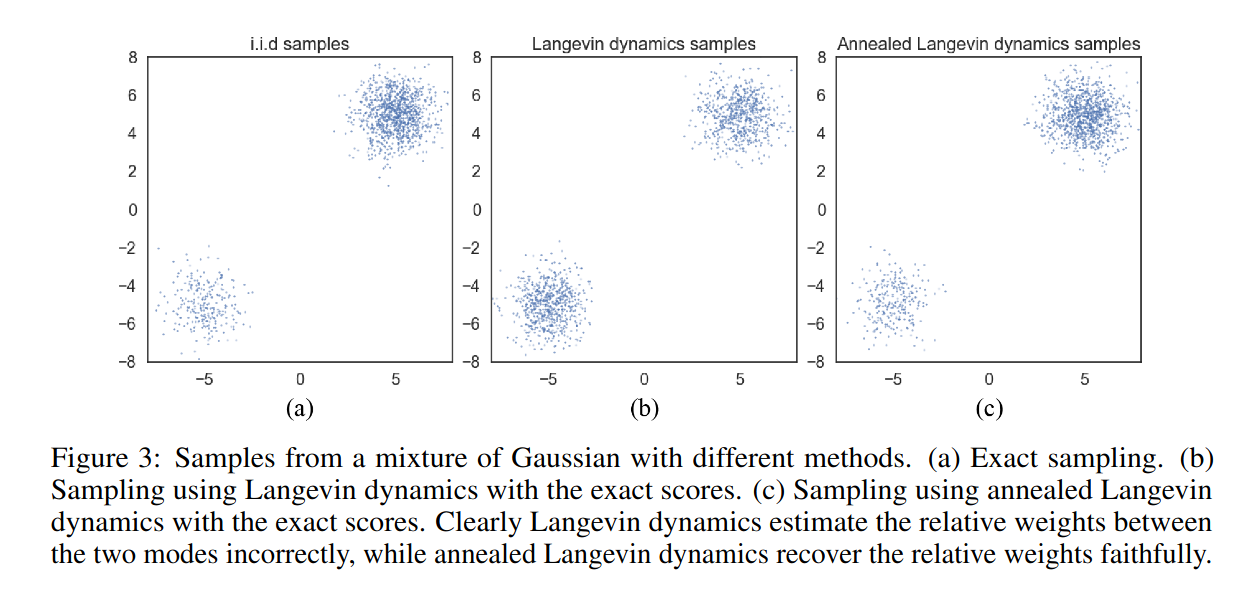
- \(\pi = 0.99\) 라면, \(p_1(x)\) 에서 많이 sampling 이 되어야 하는데 그 구분이 되어있지 않기에 문제가 생긴다.
- 이게 무슨말이냐면, 아래 수식을 봤을 때 \(p_{data}(x)\) 의 score 가 상대적인 모드의 차이를 반영하지 않았기에 모드와의 거리가 가까우면 그곳으로 간다는 얘기이다.
- 즉, 실제 분포와 상관없이 균일하게 sampling 된다는 것을 의미하고 기존의 Langevin dynamics sampling 을 사용하여 multi variative distribution 을 추정할 수 없다는 것을 의미한다.
- \(p_{data}\) 의 score 가 분포의 상대적 차이를 반영하지 않아서 우리는 sampling 을 통해 경험적으로 학습을 해야한다. 하지만, 두 모드는 낮은 밀도 영역으로 분리되어 있다고 가정했기에, 특정 모드에서 다른 모드로 넘어갈 때 밀도가 낮은 지역을 통과해야 한다는 말이 된다. 밀도가 낮은 지역은 기울기가 작기 때문에 Langevin dynamics sampling 을 통해 밀도가 낮은 지역을 횡단하기가 매우 힘들고 해당 지역의 학습 데이터 샘플도 부족하기에 score 가 부정확하다. 따라서, sampling 을 통해 경험적으로 모드 간의 분포 차이를 학습하기 어려워진다.
- 이 문제는 large noise 를 더해, low density 를 채워서 추후에 해결한다.
- 그렇다면, 이전에 제시된 Denoising Score Matching 은 이런 문제를 왜 해결하지 못했는지에 대해 살펴보자
- Denoising Score Matching 의 Loss function 은 다음과 같다.
- 우리는 \(p(x)\) 가 다변량 확률 분포임은 알 수 있지만, 구체적인 모형은 알 수 없다. 따라서 \(q_{\sigma}(\tilde{x})\) 로 근사하고자 했고, \(\theta\) 에 대해서 objective function 을 잘 풀어보니 \(q_{\sigma}(\tilde{x}|x)\) 의 score 를 찾는게 \(p(x)\) 의 score 를 찾는 것과 유사하다는 걸 알아냈다. 이때의 noise 는 아주 작아야 성립한다.
- \(q_{\sigma}(\tilde{x}|x) \sim N(\tilde{x}|x;x,\sigma^2 I)\) 으로 우리가 정의할 수 있기에 결국 \(q_{\sigma}(\tilde{x}|x)\) 는 다변량 가우시안 분포로 정의를 했다. 이렇게 정의했을 때, 분포를 정확하게 특정할 수 있다는 점에 주목해야한다.
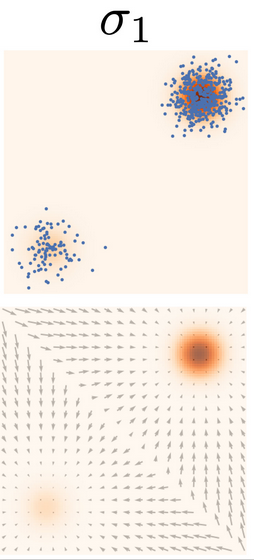
- 다시 돌아와서, 위의 \(2\) 가지 문제가 왜 생겼는지에 대해 생각해보면 결국 low density region 을 채우지 못했기에 발생하는 것이다.
- Denoising score matching 은 noise 를 아주 작게 설정해야 목적 식이 성립하기에, scalability 는 챙겼지만 low density region 은 채우지 못한 것이다.
- 두 모드를 가지는 실제 데이터 분포에 작은 노이즈를 더한 경우, low density region 이 채워지지 않는다.
Solution (NCSN)
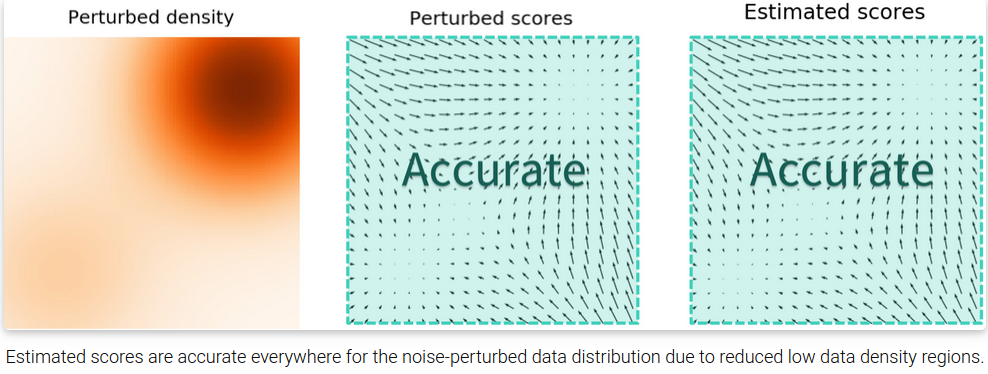
- 낮은 데이터 밀도 지역에서 정확한 score matching 의 어려움을 우회하는 해결책으로 데이터 포인트에 noise 를 적용하고 noise 가 추가된 데이터 포인트에서 score-based model 을 훈련하는 것을 제시한다.
- Noise 의 크기가 충분히 큰 경우, 낮은 데이터 밀도 지역에 데이터를 채워 넣어 estimated score 의 정확도를 향상시킬 수 있다.
- noise 를 추가하면, 데이터 분포는 smooth 해지기 때문에 데이터 밀도가 낮은 지역을 어느 정도 학습 할 수 있게 된다. 즉, 실제 데이터 분포는 아니지만 밀도가 낮은 지역에서 어디로 가야 하는 지에 대한 방향성을 제시할 수 있다.
- 그럼 우리가 생각해야 될 것은, '적절한 noise 크기를 어떻게 선택할 것인가' 이다. 큰 노이즈는 분명히 더 많은 낮은 밀도 영역을 포함하여 더 나은 score 를 추정할 수 있지만, 데이터를 지나치게 손상시키고 원래 분포에서 상당히 벗어날 수 있다. 반면 작은 노이즈는 원래 데이터 분포를 적게 손상시키지만 우리가 원하는 만큼 낮은 밀도 영역을 충분히 커버하지 못할 수 있다.
- 초기에는 noise 를 많이 더해서 low density region 에서 벗어나는 용도로 사용하고
- 시간이 지날수록 noise 를 적게 줘서, Denoising score matching 처럼 적은 noise 상태에서 정확한 \(p(x)\) 의 score 를 예측함으로써, 올바른 sampling 을 할 수 있다.
- 초기부터 정확하게 값을 추정할 필요는 없다. 즉, 방향성은 같으니 어떤 점 보단 영역을 향해 가는 느낌이다.
- 이 방법이 효과적인 이유는 다음과 같다.
- 다변량 가우시안 분포는 분산이 크다면 전체 영역을 커버할 수 있다.
- Denoising score matching 은 그러지 못했다.
- 초기 sampling 시에 큰 noise 를 더해줌으로써, low density region 을 채워줘서 방향을 제시해준다.
- 어느 영역에 도달하면, noise 를 적게 더해줘도 입력이 들어왔을 때 low density region 이 아니라는 가정이 있다.
-
Thus, 학습용 data 에 multi-scale noise 추가. 내가 가지고 있는 데이터는 확률값이 높은 곳에서 sampling 된 데이터들이고 그 데이터들로 학습을 한다. 하지만 model 을 통해 sampling 을 할 때는 초기에 랜덤하게 시작하기 때문에 확률값이 낮은 공간에서는 score 값이 부정확하다. 따라서, 큰 noise 부터 작은 noise 까지 multi-scale 로 data 에 noise 를 더해줌으로써 score 값의 방향성을 제시해준다. 그에 따라, noise 가 network 에 condition 으로 추가되고 sampling 방식도 바뀐다 (Annealed Langevin Dynamics). 즉, loss 와 sampling 의 개선
-
\(\sigma_{min}\) is small enough, \(p_{\sigma_{min}}(x) \approx p_{data}(x)\)
-
\(\sigma_{max}\) is large enough, \(p_{\sigma_{max}}(x) \approx N(x;0,\sigma_{max}^2I)\)
-
Data 에 noise 를 더하는 denoising score matching 과 유사하다. (Advanced denoising score mathcing?)
-
따라서, multiple scaled of noise perturbations 를 제안한다. (Loss 는 Denoising Score Matching with Langevin Dynamics 와 같다)
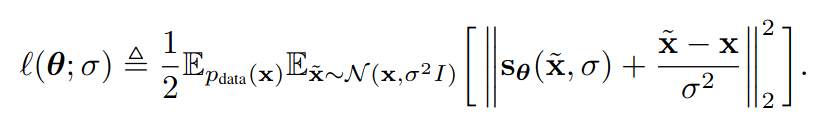
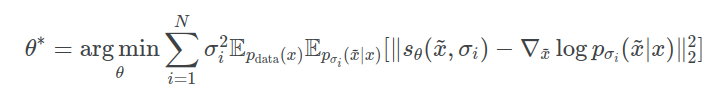
- 이건, DSBA 고려대 발표자료인데 \(\tilde{x}\) 가 아니라 \(x\) 에 대해서 미분한 거 같다.
- 아래의 그림은 2번째 항이 틀렸다.
- \(\tilde{x} - x \rightarrow x - \tilde{x}\) 로 바꿔야 된다.
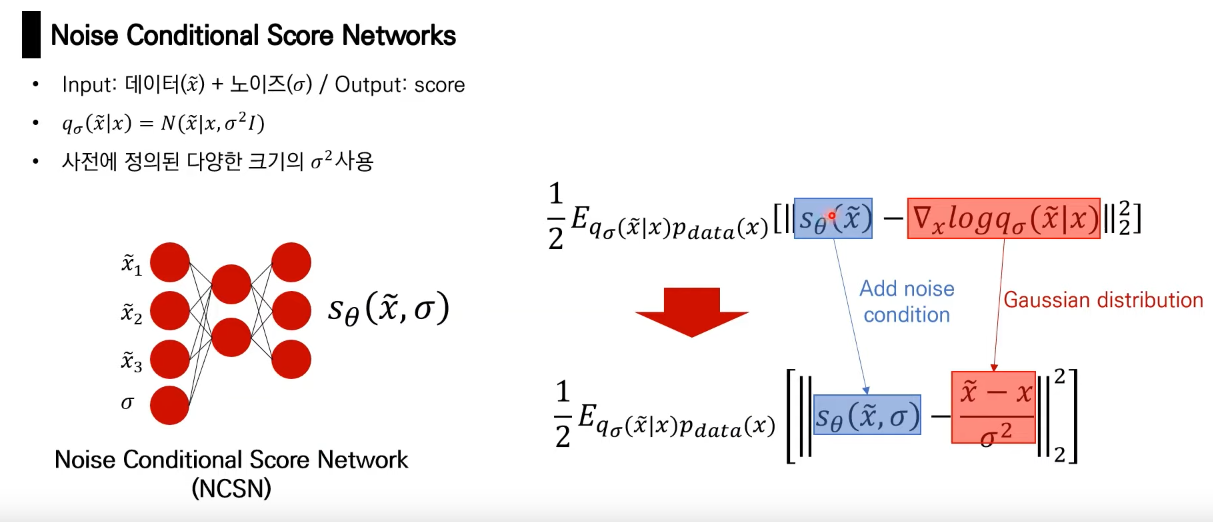
- 이때의, model 은 Noise Conditional Score-Based Model \(s_\theta(\tilde{x},\sigma)\) 로써, NCSN 이라고 부른다.
- 논문에서의 setting
- \(L\): 10
- \(\sigma_1\), \(\sigma_{10}\): 1, 0.01
- T: 100
- \(\epsilon\): \(2 \times 10^{-5}\) (noise 가 아니다)
- 논문에서의 setting
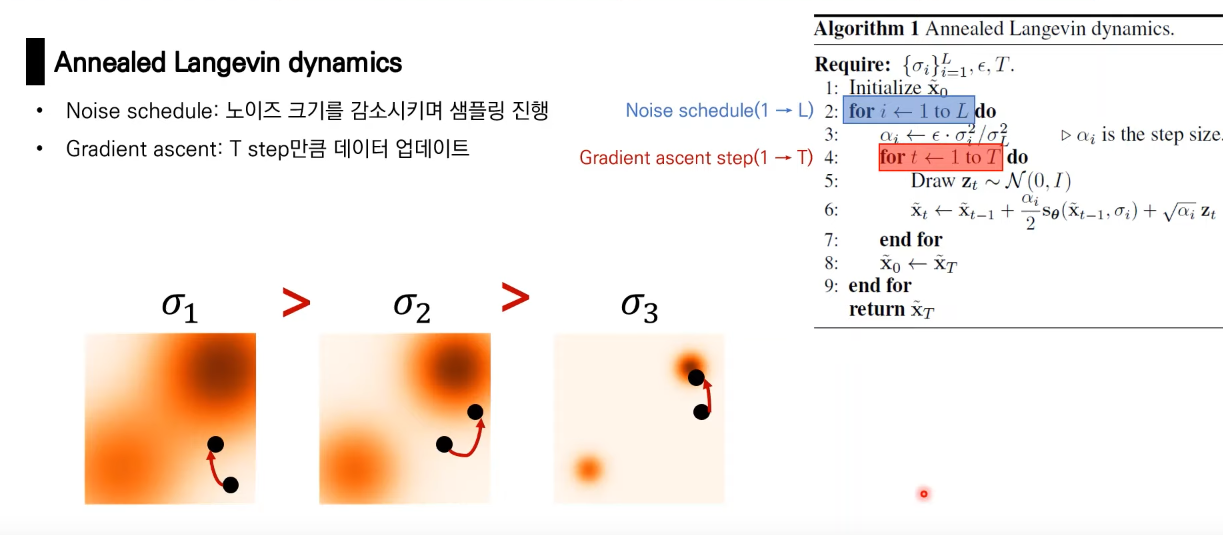
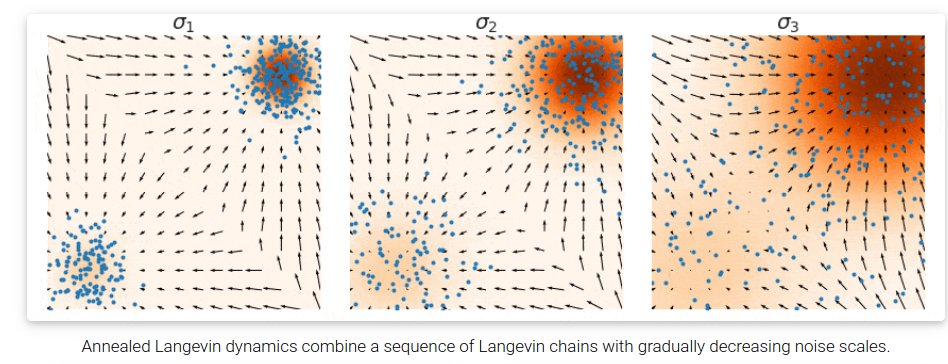
Sampling: Annealed Langevin dynamics
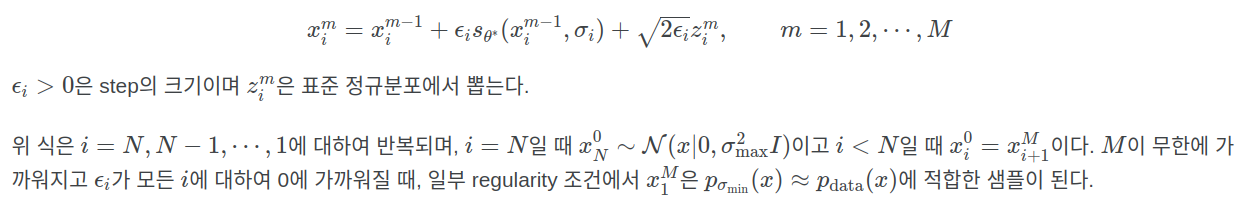
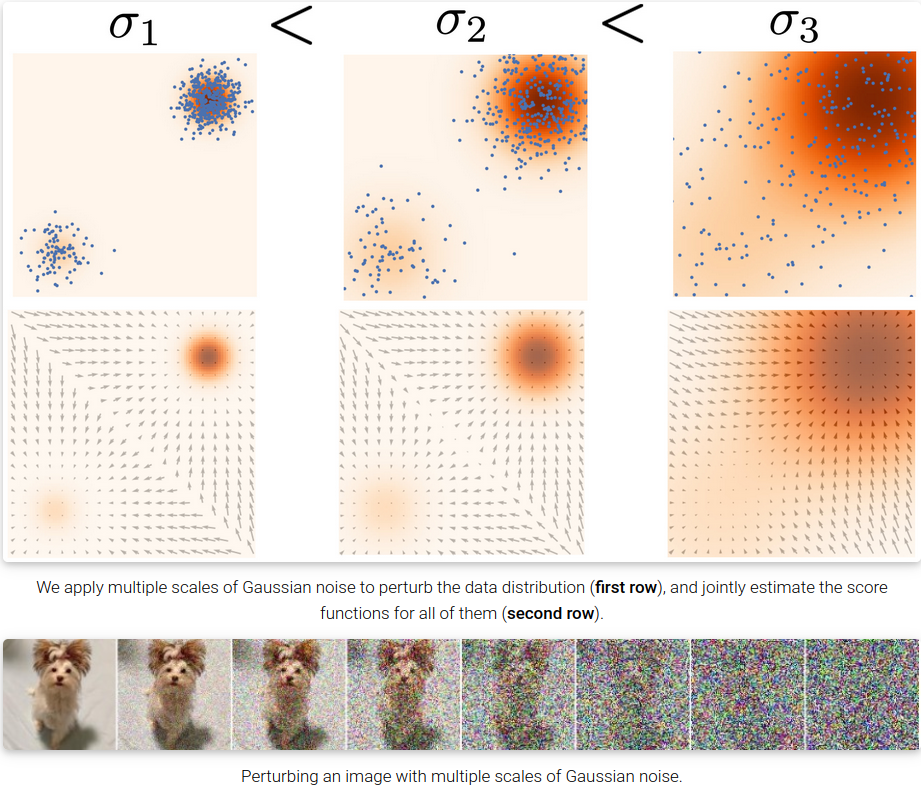
- 데이터에 noise 를 주는 것은 다음과 같이 표현할 수 있다.
- 두 mode 를 가지는 확률 분포에서, noise 를 조금 주는 것은 실제 데이터 분포와 유사하다.
- Data 에 noise 를 많이 준다면 우측 column 과 같이, 기존의 low density region 까지 data 가 분포할 수 있다. 따라서, Noise 를 많이 준 data 의 score function 을 학습한다면 내가 random 하게 뽑은 data (low density region 에 위치한) 들을 iterative 하게 sampling 했을 때 정상적으로 방향을 잡을 수가 있다.
- 이때의 파란 점은 실제 data 이다.
- 일차원으로 보면 다음과 같이 표현할 수도 있다.
- 이때의 파란 점은 내가 random 하게 뽑은 data sample 이다.
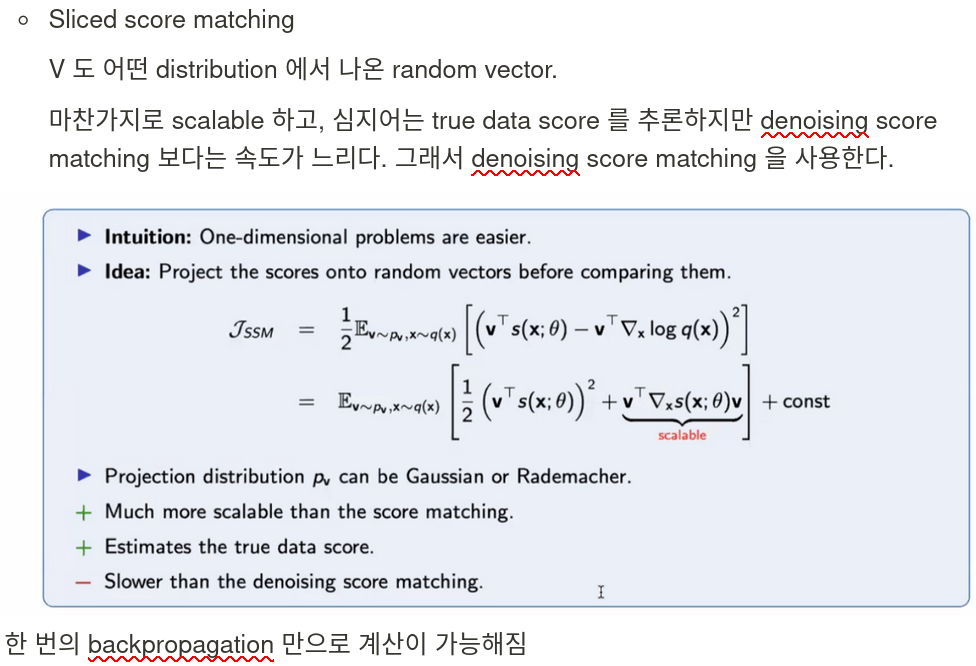
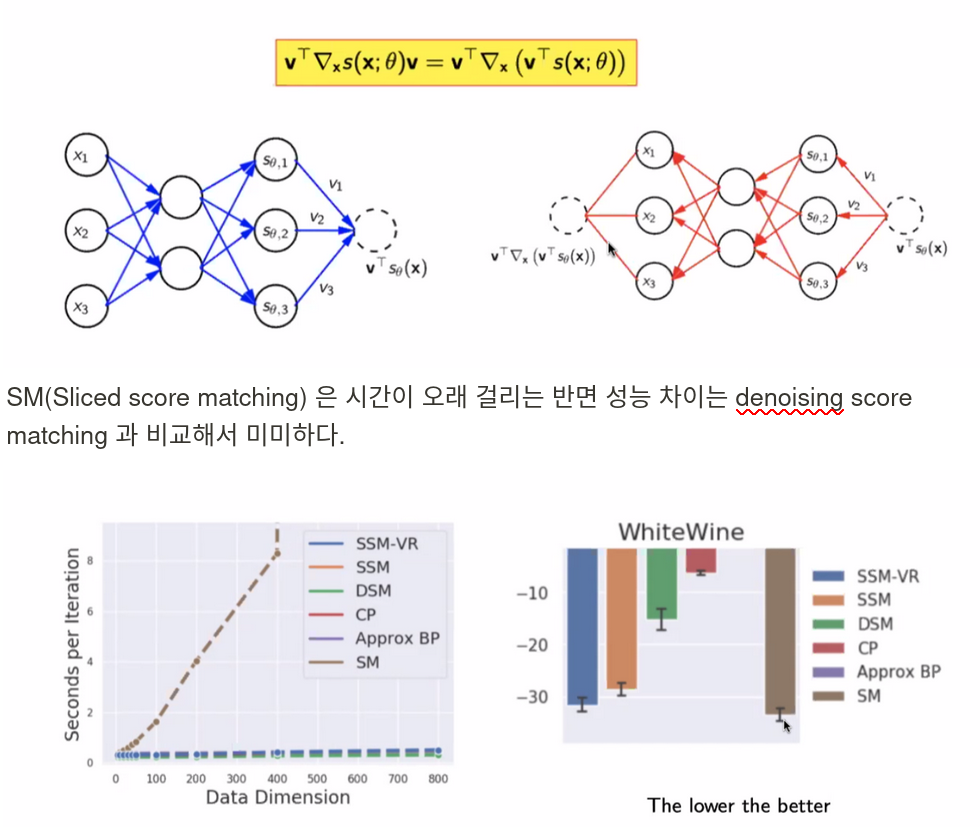
Additional Score Matching: Sliced Score Matching
Score-based generative modeling through stochastic differential equations, 2020, arXiv, 2238 citation
Probabilistic Generative Models using Noise
- 훈련 데이터를 점진적으로 늘어나는 noise 로 손상시키고, 이 손상을 역전시켜 데이터의 생성 모델을 형성하는 성공적인 \(2\) 가지 probabilistic generative models 가 있다.
- Score matching with Langevin dynamics (SMLD): score function 을 추정한 뒤, Langevin dynamics 를 사용하여 noise scale 을 감소시키면서 data 를 sampling.
- Denoising diffusion probabilistic modeling (DDPM): 각 step 에서의 noise corruption (손상) 을 reverse (역전) 하기 위해 model 을 훈련시킨다. 훈련이 가능하도록 역방향 분포의 기능적인 형태의 지식을 활용한다.
- DDPM 의 목적 함수는 암시적으로 각 noise scale 의 score fucntion 을 나타낸다.
- 본 논문에서는 SDE 관점에서 두 모델 클래스 (SMLD & DDPM) 를 score-based generative models 로 통합시킬 수 있다.
Objective Function: SMLD vs DDPM
- SMLD 에서의 NCSN 의 목적 함수를 먼저 보자.
- Sampling: Annealed Langevin dynamics 은 다음과 같다.
- 다시 목적 함수로 돌아와서, \(q_{\sigma_i}(\tilde{x}|x)\) 를 \(\nabla_{\tilde{x}}\log\) 로 씌워서 계산하면 다음과 같다. (실제로 미분하면 계산이 간단하다)
- \(\tilde{x} = x + z \ z , \sim N(0,\sigma^2I) = x + \sigma\epsilon, \ \epsilon \sim N(0,I)\)
- \(s_{\theta}(\tilde{x},\sigma_i)\) 는 다음과 같이 볼 수 있다. (둘은 같아야 하므로)
- 따라서 풀어 쓴, 최종 목적식은 다음과 같이 볼 수 있다.
- Data \(x\) 에 noise scale \(\sigma_i\) 만큼 perturbation 을 준, \(\tilde{x}\) 의 score fucntion 을 추정하는 건
- Data \(x\) 에서 noise scale \(\sigma_i\) 를 가지고 \(\tilde{x}\) 를 만들 때, 어떤 standard Gaussian noise 가 더해졌는지 찾는 문제와 같다.
- 그리고 이는, DDPM 에서의 목적 함수와 같다.
- DDPM 에서의 time step \(t\) 와 SMLD 에서의 \(i\) 는 같다.
- Time step \(t\) 는 noise scale 에 대한 정보를 주는 것과 동일하다.
- SMLD 의 noise scale \(\sigma_i\) 과 동일한 역할을 하는 것은 \(\sqrt{1-\bar \alpha_t}\) 이다.
- \(\sigma_i\) 는 hyper-parameter 이기 때문에 training 과정에선 loss 의 중요도를 판단하는 용도로 사용된다.
- E.g., \(\frac{\epsilon - \epsilon_{\theta}(\tilde{x}, \sigma_i)}{10}\) vs \(\frac{\epsilon - \epsilon_{\theta}(\tilde{x}, \sigma_i)}{1}\) 을 학습할 때, 후자에 더 비중을 두고 \(\theta\) 를 update 한다.
- DDPM 에서는 time step \(t\) 에 따라 변하는 상수 값이 존재하지만 \(1\) 로 setting 하고 학습한다. 즉, \(\sigma_i\)/\(\sqrt{1-\bar \alpha_t}\) 를 반영하는 건 선택 사항이다.
- 반대로 DDPM 의 목적식을 score function 으로 표현해보자.
- \(x_0\) 에서 perturbation 한 \(x_t\) 는 SMLD 에서의 \(\tilde{x}\) 와 같다.
- \(x_t = \sqrt{\bar \alpha_t}x_0 + \sqrt{1- \bar \alpha_t}\epsilon\) 이므로, \(p_t(x_t|x_0) \sim N(\sqrt{\bar \alpha_t}x_0,(1-\bar \alpha_t)I)\) 이다.
- \(x_t = \sqrt{\bar \alpha_t}x_0 + \sqrt{1- \bar \alpha_t}\epsilon\) 대입
- \(S_{\theta}(x_t,t)\) 도 동일하게 적용.
- 이 과정에서 DDPM 을 score function estimation 으로 보고 활용할 수 있게 된다.
- \(S_{\theta}(x_t, t) - \nabla_{x_t} \log{q_{t}(x_t|x_0)}\) 를 풀어써보면 다음과 같다.
-
SMLD 에서의 noise scale 인 \(\sigma_i\) 과 DDPM 에서의 \(\sqrt{1-\bar \alpha_t}\) 는 동일하다는 것을 다시 한 번 알 수 있다.
- 하지만 noise scale 이 동일하다고해서, 그 forward process 나 backward process 가 동일한 것은 아니다.
- DDPM 에서는 noise scale 만 있는 것이 아니라 signal scale 또한 존재한다.
- Signal scale: \(\sqrt{\bar\alpha_t}\) 로써, \(x_0\) 를 scaling 하여 \(t \rightarrow \infty\) 일 때, pure noise \(\sim N(0,I)\) 을 가게 해주는 용도로 사용된다.
-
DDPM sampling
- 이때의 \(\sigma_t\) 는 SMLD 에서의 \(\sigma_i\) 와는 다르다. \(\sigma_i\) 는 \(x_0\) 에서 \(x_t\) 로의 noise scale 이라면, \(\sigma_t\) 는 \(t\) 에서 \(t-1\) 로 가는 reverse process 의 표준편차이다.
- DDPM 의 sampling 도 score function 으로 표현해보면 다음과 같다.
- \(\sigma_t = \sqrt{\beta_t}\) 로 본다.
-
정리해보자면, SMLD 와 DDPM 모두 \(x_0\) 가 주어졌을 때 perturbation 된 \(x_t\) 의 score function 을 estimation 하는 것이다. 즉, 목적 함수가 동일하다.
- 여기서 DDPM 의 경우, Marcov Property 를 가지기에 예측한 noise 가 이전 time step 에 관한 noise 인지 \(x_0 \rightarrow x_t\) 에 관한 noise 인지 헷갈릴 수도 있다.
- 하지만 DDPM loss 전개 시에, KL-Divergence 를 계산하는데 \(x_t = \sqrt{\bar \alpha_t}x_0 + \sqrt{1- \bar \alpha_t}\epsilon\) 를 이용해 \(x_0\) 를 \(x_t\) 로 표현하는 과정에서 나온 노이즈여서 \(x_t\) 까지의 noise 를 의미한다.
-
SMLD 의 Objective function & Sampling method
- DDPM 의 Objective function & Sampling method
SDE: Stochastic Differential Equation
-
Diffusion coefficient \(g(t)\) 가 일반적인 SDE 에서와는 달리, \(x_t\) 는 입력으로 받지 않는다.
-
Forward SDE: noise 를 점진적으로 더하는 과정 (data \(\rightarrow\) noise)
- Reverse SDE: noise 를 점진적으로 제거하는 과정 (noise \(\rightarrow\) data)
- SDE 가 존재한다면, reverse-time SDE 또한 존재한다.
- Anderson (1982) 증명
- 이때의 \(\nabla_x \log p_t(x)\) 는 "the score of the marginal probability densities as a function of time" 즉, \(t\) 에 대해서 marginalize 를 한 것이다. (모든 \(t\) 에 대해서 적분)
-
이제, 이산적인 process 였던 SMLD 와 DDPM 을 연속적으로 보자
-
Variance Exploding SDE: SMLD
- SMLD 의 \(p_{\sigma}(x_i|x_0) = x_i = x_0 + \sigma_iz_i, \ z \sim N(0,I)\) 를 이용하여 Markov chain 을 따르는 수식을 만들어보자.
- \(x_0\) 를 \(x_{i-1}\) 에 대해서 잘 표현해보면 Markov chain 을 만족시킬 수 있을 거 같다.
-
- \(x_{i-1} = x_0 + \sigma_{i-1} z_{i-1}\) 를 \(x_0\) 에 대해서 표현해보자.
-
- \(x_0 = x_{i-1} - \sigma_{i-1}z_{i-1}\) 을 대입해보자
-
- \(x_i = x_{i-1} - \sigma_{i-1}z_{i-1} + \sigma_iz_i\) 로 만들어진다.
- 이때, 정규 분포를 따르는 두 확률 변수의 합은 다음과 같이 표현된다.
- 따라서, \(x_i = x_{i-1} + \sqrt{\sigma_i^2 - \sigma_{i-1}^2}z_{i-1}\) 로 표현할 수 있다.
- \(t = \frac{i}{N}, x(\frac{i}{N}) = x_i, \sigma(\frac{i}{N}) = \sigma_i, z(\frac{i}{N}) = z_i, \Delta t = \frac{1}{N}\) 로 정의하고 \(N \rightarrow \infty\) 로 보내면, 다음과 같이 표현할 수 있다.
- E.g., \(x_{i+1} = x(\frac{i+1}{N}) = x(\frac{i}{N}+\Delta t) = x(t+\Delta t)\)
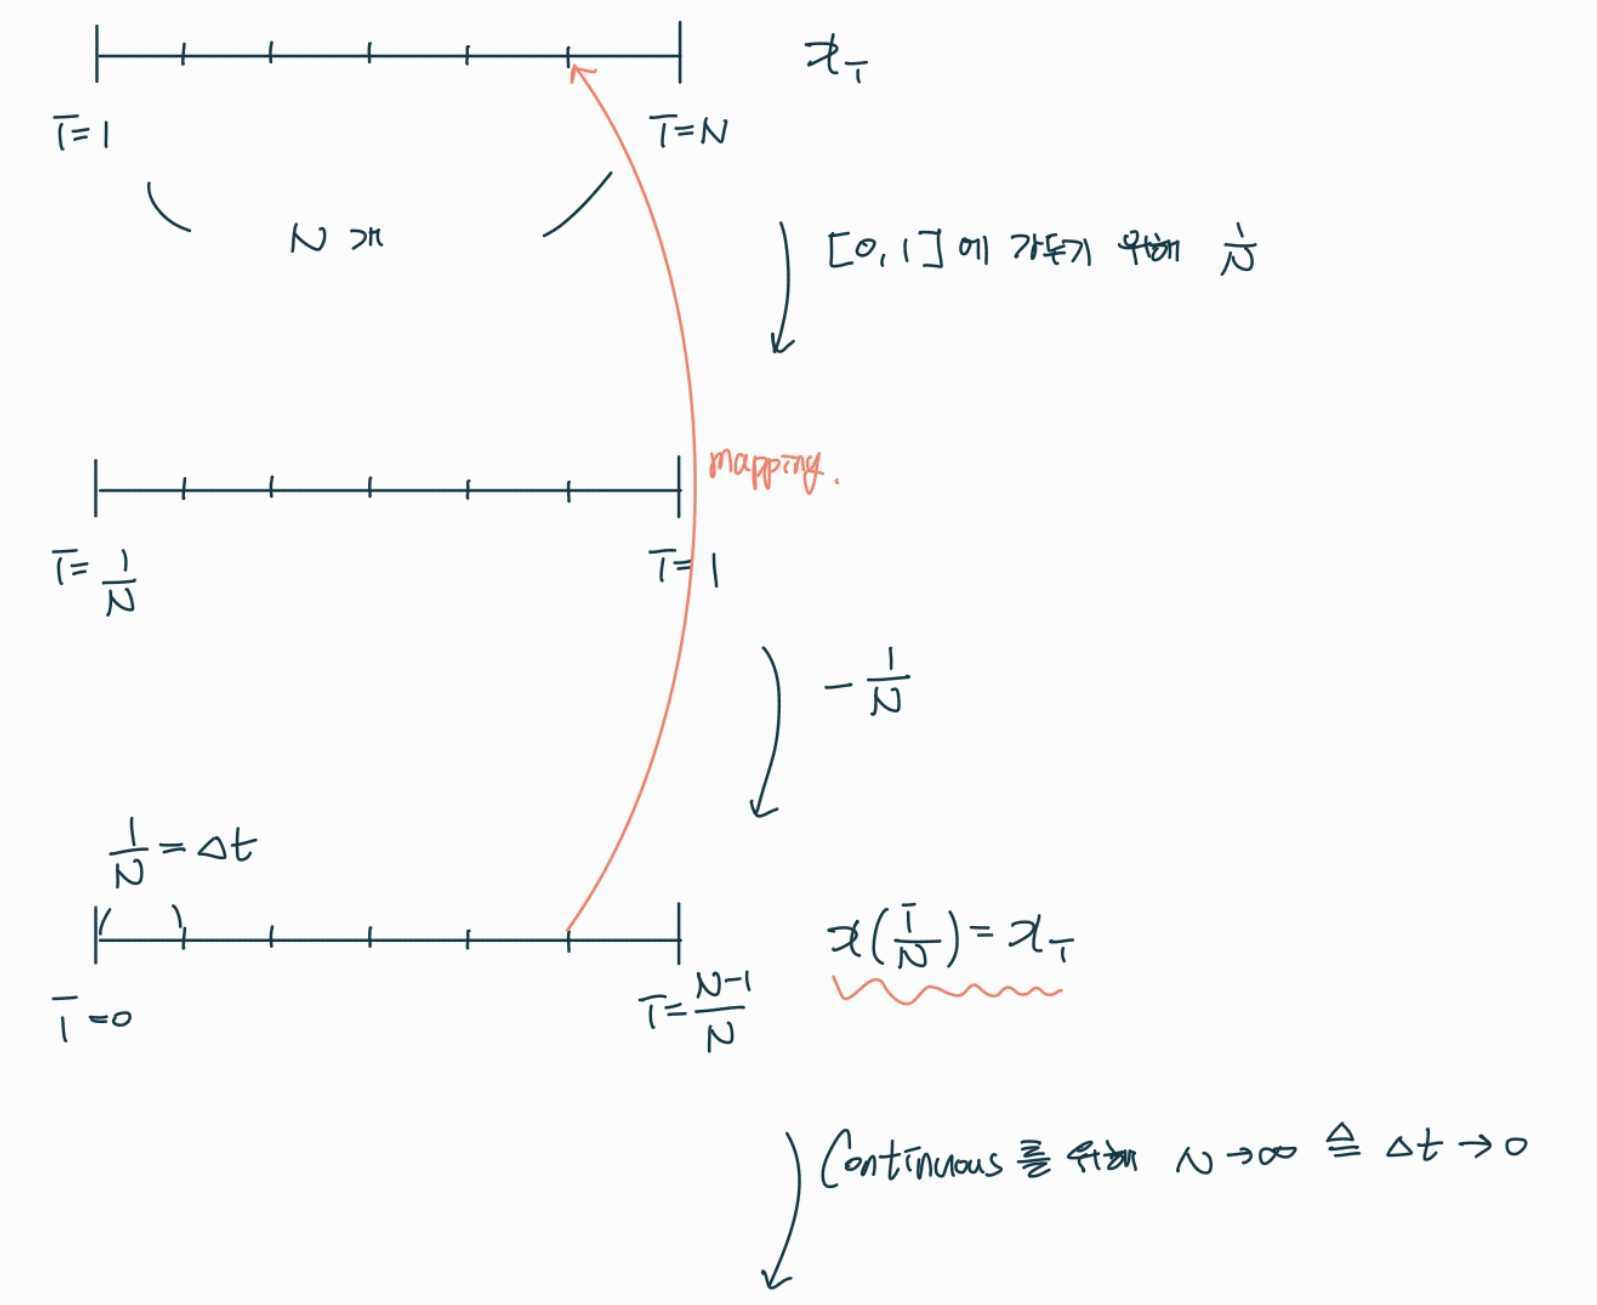
- Taylor's Series 의 first-order 를 이용하면 다음과 같이 근사할 수 있다.
- 이때, \(\Delta t << 1\) 이어야 근사가 가능하다. \(t\) 점과 멀리 떨어져 있으면 안된다.
- 우리는 SDE 에서 Brownian motion 이 다음의 성질을 갖는 걸 알고 있다.
- Continuous time 으로 보내기 위해 \(\Delta t \rightarrow 0\)
-
여기서 우리는 SMLD 의 noise injection 을 forward SDE 로 표현했다.
-
Variance Preserving SDE: DDPM
- DDPM 의 forward process in discrete time 을 보자.
- \(z_{i-1} \sim N(0,I)\)
- DDPM 의 forward process in discrete time 을 보자.
- \(\beta_i = \frac{\bar \beta_i}{N}\) 으로 정의해보자.
- \(\beta(\frac{i}{N}) = \bar \beta_i, x(\frac{i}{N}) = x_i, z(\frac{i}{N}) = z_i, \Delta t = \frac{1}{N}\) 로 정의하고 \(N \rightarrow \infty\) 로 보내면, 다음과 같이 쓸 수 있다.
- 위와는 다르게 Taylor's series 를 전개해보자
- \(x = \beta(t+\Delta t)\Delta t\) 로 치환하고, \(f(x) =\sqrt{1 - x}\) 로 본다.
- \(\beta\) 는 다음과 같은 범위를 지니고 있다. \(0 < \beta < 1\) (DDPM 에서는 \(0.0001 \sim 0.02\))
- 따라서, \(\Delta t << 1\) 일때, \(x = a = 0\) 에 가까울 것이다.
- \(\Delta t << 1\) 인 조건하에, \(x= a = 0\) 인 지점으로 보고 맥클로린 급수 (\(a=0\) 인 테일러 급수)를 사용하여 근사할 수 있을 것이다.
- \(x = \beta(t+\Delta t)\Delta t\) 로 다시 치환해보자.
- 최종적으론, 다음과 같이 근사할 수 있다.
- \(\beta(t+\Delta t) \approx \beta(t)\): \(\beta\) 자체가 \((0,1)\) 의 범위를 지니기 때문에 (실제로는 더 작음) \(\Delta t << 1\) 일 때는 근사가 가능하다?
- \(\Delta t \rightarrow 0\),
-
Noise 를 더해서 내가 아는 분포로 표현하는 건 동일하다. 하지만 DDPM 은 noise 를 더함으로써, pure noise 로 만들었고, SMLD 는 low density region 을 채웠다.
- 서로 달라 보이는 이 과정들이 SDE 관점에서는 어떤 forward SDE 를 선택하냐에 따라서 다른 class 로 볼 순 있지만 사실, 같은 framework 에서 작동한다.
- VE/VP SDE 의 discretization: SMLD/DDPM
-
VP SDE (DDPM) 에서는 pure noise 에서 sampling 하면 되는데 VE SDE (SMLD) 에서는 variance exploding 이여서 pure noise 는 아니고 평균이 data \(x\) 이다. 따라서 signal 이 있으나 마나하게 variance 를 엄청 크게 주고 초기에 sampling 을 하는 게 맞지만, DDPM 과 동일하게 pure noise 에서 sampling 하는 것 같다.
- NCSN paper 에서는 \(\sigma_{max}\) is large enough, \(p_{\sigma_{max}}(x) \approx N(x;0,\sigma_{max}^2I)\) 로 표현했다.
-
그렇다면 왜 VE/VP SDE 라는 명칭이 붙었을까?
- 사실 수식으로 증명되어 있지만, 이해하기가 어렵기 때문에 직관적으로 보자.
- VE SDE discretization: \(i\) 가 커지면 커질 수록 \(\sigma_i^2\) 의 값은 커지는데 \(\sigma\) 값의 범위가 정해져있지 않으므로 exploding 할 수 있다.
- VP SDE discretization: \(i\) 가 커지면 커질 수록 \(\bar \alpha_i\) 의 값은 \(\beta_i\) 값의 범위가 \((0,1)\) 로 정해져있기 때문에 \(0\) 에 수렴하게 된다. 즉, variance 가 \(1\) 에 수렴하게 된다.
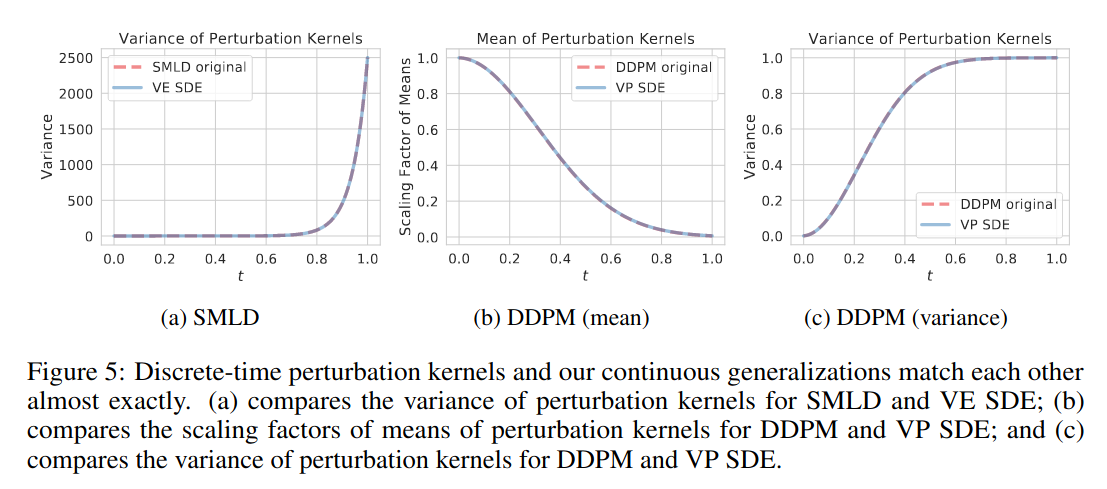
- 실제 논문에서 실험을 했을 때, discretization 과 continuous version 의 분산이 동일하게 작동하는 것을 볼 수 있다.
- SMLD 의 분산은 발산
- DDPM 의 분산은 \(1\) 에 수렴
\(\sigma(t) \And \beta(t)\) definition
- Forward SDE
- In SMLD, \(\sigma(t) = \sigma_{min}(\frac{\sigma_{max}}{\sigma_{min}})^t\) and \(\sigma_i = \sigma_{min}(\frac{\sigma_{max}}{\sigma_{min}})^{\frac{i-1}{N-1}}\)
- \(\sigma_0 = 0\)
- \(\sigma_0 = 0\) 인데, 정의한 \(\sigma(t)\) 에 \(t=0\) 을 대입하면 \(\sigma_{min}\) 이 나온다. 즉, 실제로는 \(t \in [\epsilon,1]\) 의 범위를 사용한다. \(\sigma(0^+) = \sigma_{min}\) (\(\epsilon = 10^{-5}\) in paper)
- In DDPM, \(\beta_i = \frac{\bar \beta_{min}}{N} + \frac{i-1}{N(N-1)}(\bar \beta_{max} - \bar \beta_{min})\)
- In the limit of \(N \rightarrow \infty\)
- 마찬가지로 \(t \in [\epsilon,1]\) 의 범위에서 구현
Solving the Reverse SDE
- General Form
-
Numerical SDE solvers = Predictor
- 아래의 \(3\) 가지 방법들은 모두 reverse-time SDE 를 서로 다른 방식으로 discretization 한 것이다.
-
- Reverse Diffusion Sampling: Euler-Maruyama Method 에 따른 discretization strategy
-
- Ancestral Sampling: 미리 정의한 조건부 확률 분포 \(\displaystyle\prod_{i=1}^N p_{\theta}(x_{i-1}|x_i)\) 로부터 이미지를 sampling 하는 방법
-
DDPM sampling
- Reverse-time VP SDE 의 special discretization
- 위 수식을 reverse diffusion sampling method 의 식으로 바꿔보자.
- First-order Taylor's series 로 \(\frac{1}{\sqrt{1-\beta_i}}\) 를 근사한다.
- \(x = \beta_i, f(x) \approx f(a) + f'(a)(x-a), \ a = 0\) 을 이용
- \(o(-)\) 는 error 값이다.
- \(\frac{1}{2}\beta_i^2S_{\theta}(x_i,i)\) 가 아주 작은 값이니 소거
- \(- \sqrt{1- \beta_i}\) 를 first-order Taylor 근사를 하면 \(-1 + \frac{1}{2}\beta_i + o(\beta_i)\) 가 나온다.
-
DDPM 의 Ancestral sampling 을 Reverse Diffusion sampling 의 \(2\) 가지 version 으로 바꿀 수 있다.
-
SMLD model 또한 마찬가지로, DDPM 처럼 ancestral sampling 으로 표현할 수 있다.
- Reverse Diffusion sampling 이 아님에 주목
- DDPM paper 에서 제안한 방법처럼 유도하면 된다.
- \(\sigma_1 < \sigma_2 < \cdots < \sigma_N\)
- Ancestral Sampling of SMLD
-
- Probability Flow
Probability Flow ODE (PF ODE)
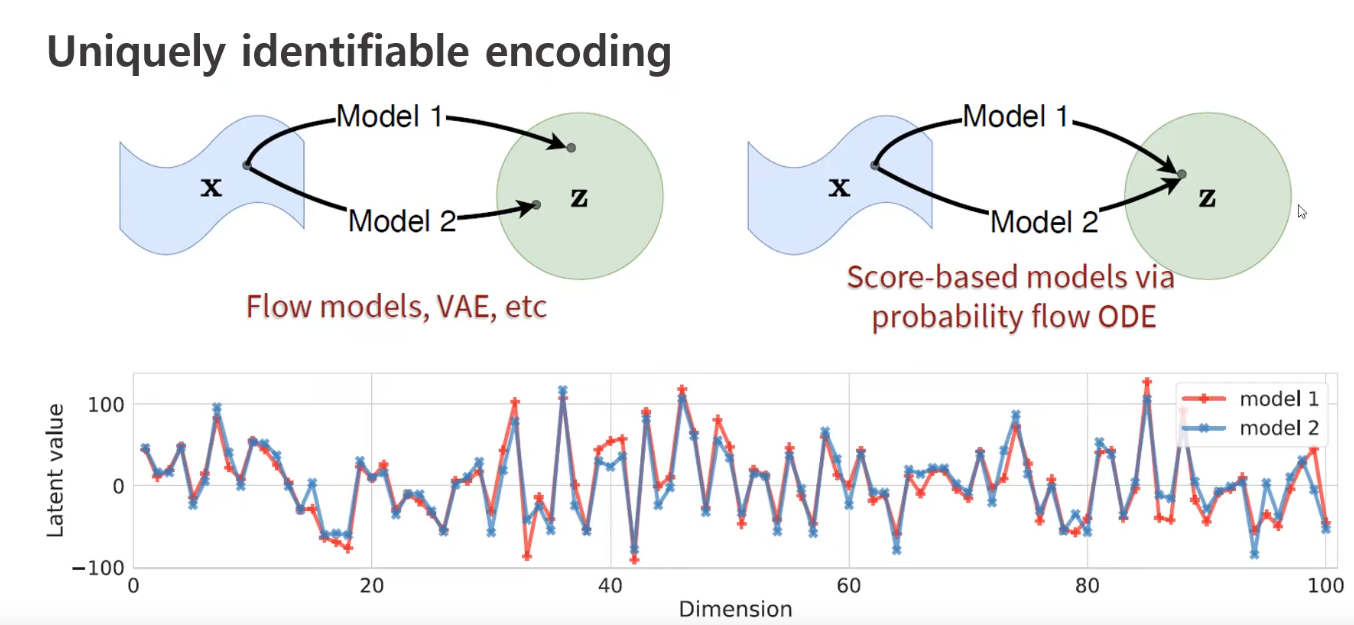
Forward SDE 와 동일한 확률 분포를 갖는 ODE
- \(z_i \sim N(0,I)\) 를 필요로 하지 않기에, deterministic sampler 이다.
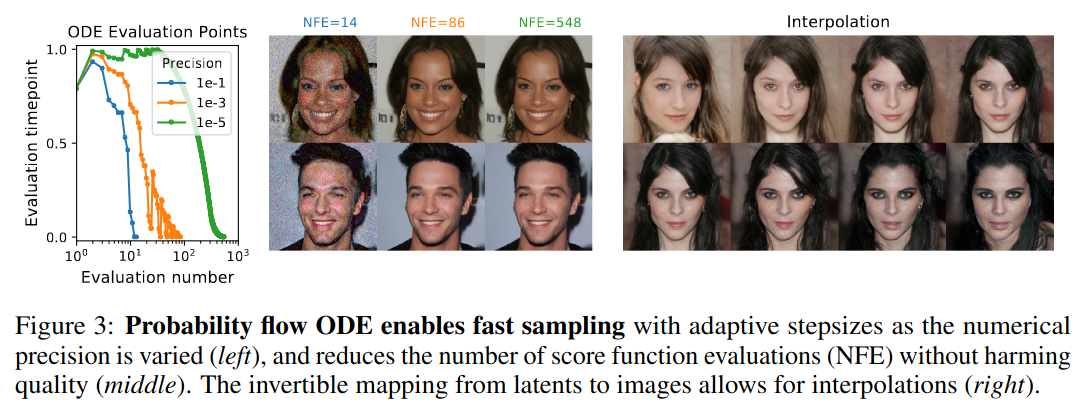
- Fast sampling
- Smooth interpolation
-
Exact likelihood computation
-
PF ODE
- Deterministic process 이기 때문에 data \(x\) 가 주어졌을 때, unique 한 latent vector \(z\) 도 구할 수 있다.
- Interpolation & Fast sampling
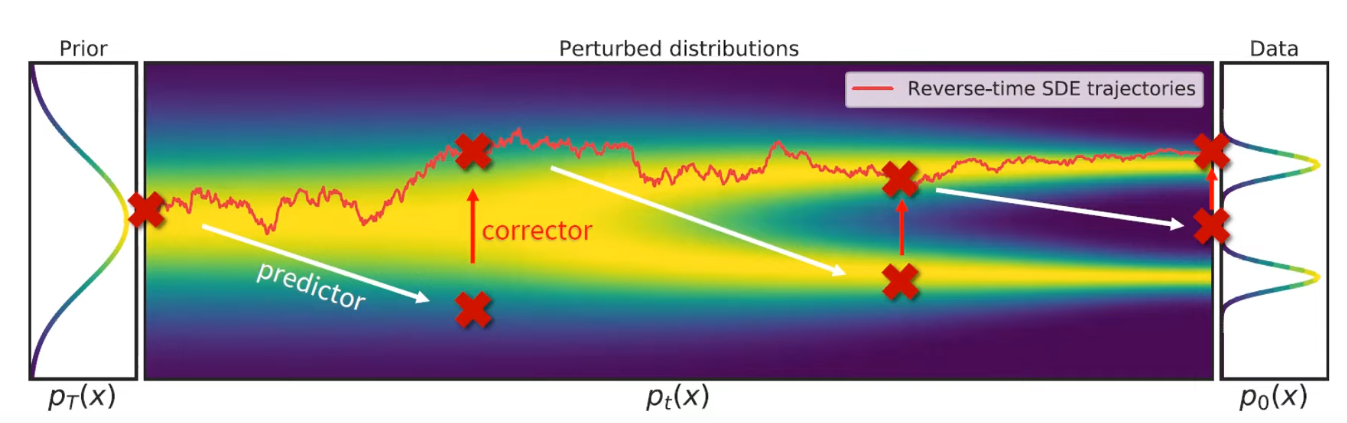
Predictor and Corrector (PC) sampler
-
Predictor: time step 을 옮길 때 사용
- Ancestral sampling, reverse diffusion sampling, probability flow sampling
-
Corrector: 특정 time step 에서 값을 조정
- Any score-based MCMC approach
- E.g., Langevin dynamics
-
SMLD 는 predictor 를 identity, corrector 를 annealed Langevin dynamics 를 쓴 꼴이다.
- DDPM 은 predictor 를 ancestral sampling, corrector 를 identity 를 쓴 꼴이다.
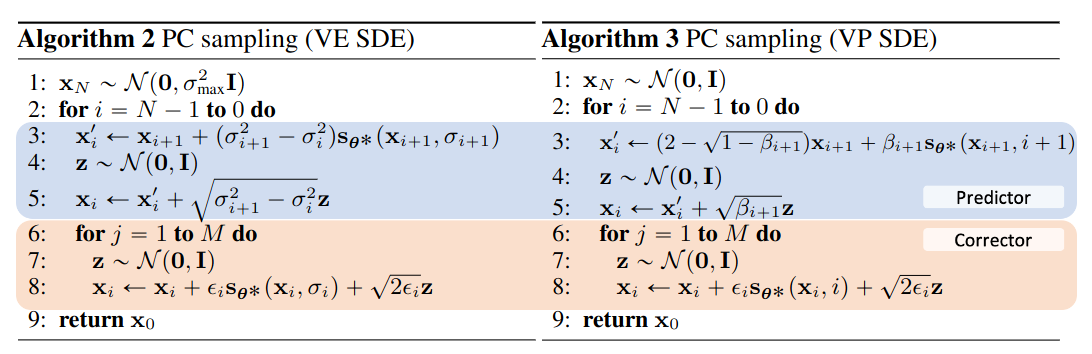
- Predictor & Corrector algorithm
- Corrector 는 langevin dynamics 로 동일하다.
- Algorithm 2. VE SDE: predictor 는 VE reverse diffusion sampling
- Algorithm 3. VP SDE: predictor 는 VP reverse diffusion sampling
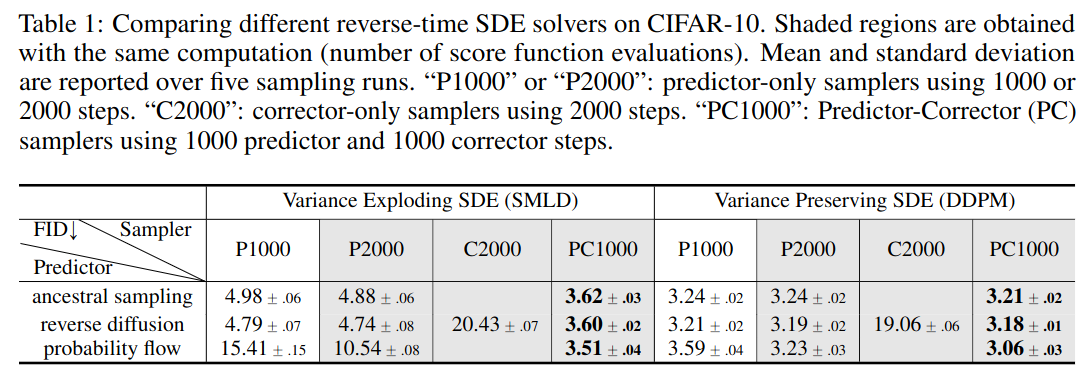
Experimental Results
- Predictor + Corrector 를 함께 쓰면 성능이 더 좋다.
- Probability Flow 를 predictor 로 사용하는 경우에 성능이 가장 좋았다.
- \(C2000\) 의 경우, corrector 만 사용한 실험이기에 predictor 와는 관계없이 결과가 일정해서 하나로만 결과를 표시했다.
Contribution
-
첫 번째 contribution
- SDE 를 통해 DDPM 과 SMLD 를 하나의 framework 로 통합시킨다.
- DDPM 과 SMLD 는 SDE 관점에서 SDE 의 discretization 이자, 어떤 forward SDE 를 선택하는가에 따라 다른 class 이다.
- VE/VP SDE 로 확장
-
두 번째 contribution (첫 번째 contribution 의 연장선)
- 해당 수식을 classifier guidance 및 classfier-free 에 사용한다.
- 이 수식이 말하고자 하는 것은, \(\beta\) 및 \(\alpha\) 가 상수 값이니 결국 \(\epsilon\) 을 학습하는 게 score function 을 학습하는 것과 같다라는 말이다. (목적함수가 동일)
-
세 번째 contribution via Probability Flow ODE
- Deterministic 하게 sampling 을 하게 되면 continuous normalizing flow 가 돼서, likelihood 계산을 정확하게 할 수 있다.
- One-to-One map 이기 때문에, 데이터가 정해지면 latent vector 가 정해져서 smooth interpolation 이 가능하다.
- Fast sampling
-
네 번째 contribution
- Score network 의 modularity 로 인해, controllable generation 이 가능하다.
Conclusion
- 정리를 해보자면, NCSN 과 DDPM 의 forward process 를 general 하게 continuous time 으로 보냈더니, SDE (stochastic differential equation) 의 VE/VP discretization (시간 차이가 \(1\) 인) 으로 볼 수 있었다.
- 이 과정에서 NCSN 과 DDPM 의 목적 함수도 같다는 걸 알 수 있었다.
- \(x_0 \rightarrow x_t\) 까지 더해진 noise prediction
- 이 과정에서 NCSN 과 DDPM 의 목적 함수도 같다는 걸 알 수 있었다.
- Forward SDE 가 정의되면, reverse-time SDE 도 정의할 수 있다.
-
\(f(x,t)\) 와 \(g(t)\) 를 먼저 정의해보자
- VE SDE: \(f(x,t) = Null\), \(g(t) = \sqrt{\frac{d \sigma^2(t)}{dt}}\)
- VP SDE: \(f(x,t) = - \frac{1}{2}\beta(t)x(t)\), \(g(t) = \sqrt{\beta(t)}\)
-
Reverse SDE 에 필요한 요소를 모두 구했으니, Numerical SDE Solver(=Predictor) 로 Reverse SDE 를 discretization 하자.
- 실제로 generation 할 때는 discrete env (e.g., computer) 로 할 테니 이산화를 해야한다.
- 시간 차이는 \(1\) 로 setting
- 총 \(3\) 가지 방법을 소개한다. (Reverse Diffusion Sampling, Ancestral Sampling, Probability Flow ODE)
-
Euler-Maruyama Method
- Euler-Maruyama Method 에 따른 discretization strategy 를 본 논문에서는 reverse diffusion sampling 이라고 명명했다.
- VE Reverse SDE
- VP reverse SDE
- 사실 두 개의 수식은 같은 수식으로 볼 수 있다. 하지만, Forward SDE 를 정확하게 Reverse-time SDE 로 표현한 것은 맨 위의 수식이다.
- 논문에서는 아래 수식을 이용했다.
-
Ancestral Sampling
- NCSN 과 DDPM 에서 쓴 sampling 방식이다. Special sampler 로 볼 수 있고, reverse-time SDE format 에는 맞지 않아서 따로 정의한 거 같다.
- 실제로 NCSN 에서는 sampling 방식을 제시하지 않았지만, DDPM 처럼 풀어서 쓰면 ancestral sampling 을 구할 수 있다.
- Ancestral sampling 을 근사하게 되면, Euler-Maruyama Method 를 구할 수 있다.
- NCSN 에서 사용한 sampler 인 Langevin dynamics 는 Nemerical SDE solver 가 아닌, MCMC sampler 여서 추후에 corrector 에서 사용한다.
-
VE Reverse SDE
- VP reverse SDE
- Probaility Flow ODE (PF ODE)
- Reverse-time SDE 와 동일한 확률 분포를 갖는 ODE 이다.
- \(z_i \sim N(0,I)\) 를 필요로 하지 않기에, deterministic sampler 이다
- Fast sampling
- Smooth interpolation
- Exact likelihood computation
- Deterministic process 이기 때문에 data \(x\) 가 주어졌을 때, unique 한 latent vector \(z\) 도 구할 수 있다.
- VE Reverse SDE
- VP reverse SDE
-
마지막으로 우리가 실제 구현시에 이용할 수식들은 다음과 같다.
- 우리는 continuous time 으로 구현할 수 없어서 모든 수식을 이산화해서 구현해야한다.
- VE 를 고르면 VE 에 맞는 수식들만 써야 한다. VP 도 마찬가지.
-
Forward process (\(x_0 \rightarrow x_t\))
- Training Objective Function
- \(\sqrt{1-\bar \alpha_t} \ \text{in DDPM} = \sigma_t \ \text{in SMLD}\)
- Reverse process (Generation): predictor + corrector
predictor
-
Reverse Diffusion Sampling
-
For VE SDE,
- For VP SDE,
-
Ancestral Sampling
-
For VE SDE,
- For VP SDE,
-
Probability Flow ODE (PF ODE)
-
For VE SDE,
- For VP SDE,
corrector
- Langevin dynamics
Question
- Denoising Score Matching 의 목적함수는 NCSN 에서도 사용된다. 여기서 궁금한 건 \(q(\tilde{x}|x)\) 가 모드가 하나인 다변량 가우시안 분포라는 것이냐다. 이게 왜 중요하냐면 결국 모드가 하나라면 score fucntion 은 어디서 sampling 이 되든 한 곳으로 모일 것이다. 이건 올바른 학습 방법이 아니다.
- 자문자답을 해보자면, \(q(\tilde{x}|x)\) 는 하나의 모드를 가지는 다변량 가우시안 분포가 맞지만 어떤 \(x\) 가 주어지냐에 따라 바뀌기 때문에 상관없다. 무슨 말이냐면, \(x\) 가 결국 langevin dynamics 를 통해 계속 바뀐 상태로 network 의 입력으로 들어갈텐데 그때마다 model 은 다른 다변량 가우시안 분포를 예측하기에 사실상 하나의 분포를 고정시켜놓고 올라타는 게 아니라는 말이다. 물론 특정 영역안에 들어가면 입력이 들어왔을 때, model 이 생각하는 다변량 가우시안 분포가 유사해서 수렴을 할 거 같긴 하다.