Virtual Try-On (VITON)
VITON (Virtual Try On)
가상 옷 fitting
Definition
- Target person 에게 원하는 옷을 가상으로 입히는 task 이다.
Type of Task
- Prompt-based Virtual Try On
- ControlNet
- Multimodal Garment Designer
- EditAnything
- Image-based (2D) Virtual Try On
- VITON
- CP VITON
- LA-VITON
- CP-VTON+
- C-VTON
- ACGPN
- PF-AFN
- VITON-HD
- Dress Code
- Single Stage Virtual Try-on via Deformable Attention Flows
- High-Resolution Virtual Try-On with Misalignment and Occlusion-Handled Conditions
- C-VTON: Context-Driven Image-Based Virtual Try-On Network
- TryOnDiffusion
- GP-VTON
- DCI-VTON
- LADI-VTON
- Stable VITON
- Multi-Pose Guided Virtual Try On
- Video Virtual Try On
- Non-clothing Virtual Try On
- Pose-Guided Human Synthesis
- Datasets for Virtual Try On
- In the Wild Virtual Try On
- Etc. (3D Virtual Try On, Mix-and-match Virtual Try On ...)
Image-based (2D) Virtual Try On
- 소비자가 원하는 contents 를 생성하기 위해선 좋은 text prompt 를 작성하는 것은 복잡한 prompt 엔지니어링이 필요한 경우가 많기 때문에 쉽지 않다. 또한, text 는 복잡한 장면이나 개념을 표현하는 데에는 유익하지 않아 콘텐츠 제작에 방해될 수 있다.
- 그에 반해, 이미지는 텍스트에 비해 더 많은 내용과 디테일을 표현할 수 있다.
Difficulty
- 옷을 입혔을 때의 artifacts
- 체형이 바뀜에 따른 옷의 변화 (주름, 근육의 표현 등)
- 옷의 길이에 따른 변화
- 옷의 길이 조절
- Target person 이 긴팔을 입고 있는데, 반팔을 입히려면 target person 이 반팔을 부족한 정보 (e.g., 팔의 모양, 길이, 포즈, etc.)를 model 이 채워야한다.
- 문신 및 시계 등 악세서리의 보존
- 생성 시에 없어지는 경우가 많다.
- target person 과 그 배경은 유지한채 옷만 바꿔야 한다.
Training Approach
Dataset
크게 \(2\) 가지 (VITON-HD, Dress Code) 정도가 존재한다.
- VITON-HD (\(11,647/2,032\)) (\(1024 \times 768\) resolution)
- Dress Code (\(1024 \times 768\) resolution)
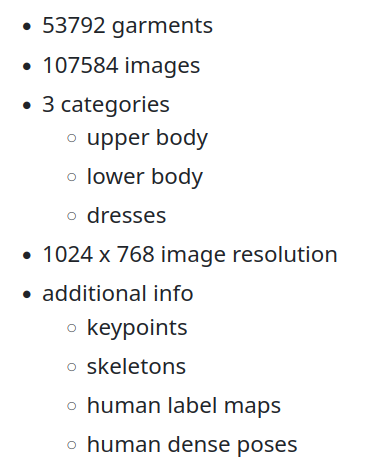
- SHHQ-1.0
-
AI hub in Korea
-
VITON paper 에서 사용한 dataset set 은 VITON-HD 의 lower resolution 이라고 보면 된다.
- \(256 \times 192\)
Comparison Methods
VITON-HD, HR-VITON, StableVITON 은 같은 저자라고 보면 된다.
-
Train
- VITON-HD: VITON-HD
- HR-VITON: VITON-HD
- StableVITON: VITON-HD & Upper body in DressCode
- CP-VTON: VITON
-
Test
- VITON-HD: VITON-HD
- HR-VITON: VITON-HD
- StableVITON: VITON-HD & Upper body in DressCode & SHHQ-1.0 & Web-crawled images
- CP-VTON: VITON
-
Exception
- TryOnDiffusion: train - \(4\) Million sample, test - \(6\) K sample
-
To DO
- PF-AFN
- ACGPN
- CP-VTON
- CP-VTON+
- GP-VTON
- C-VTON
Evaluation
-
VITON-HD: SSIM (structural similarity), LPIPS (learned per- ceptual image patch similarit), FID ( frechet inception distance)
-
HR-VITON: FID, KID, LPIPS, SSIM
-
StableVITON: FID, KID, LPIPS, SSIM
-
Paired setting: person/original clothing
- Use SSIM, LPIPS
-
Unpaired setting: person/different clothing
- Use KID, FID
-
Exception
- TryOnDiffusion: FID, KID
- VITON: IS
- CP-VTON: IS
My Method
\(\textbf{Problem 및 전개}\)
-
기존의 방법들: \(2\) stage system
- 우리가 ai를 쓰는 이유는 복잡한 전처리(hand crafted feature) 를 하지 않고, 간단하면서도 간편한 입력만으로도 처리할 수 있는 능력을 가진 ai를 활용하는 것. 하지만 기존의 방법들은 투스테이지로, 후처리도 해야하고, 학습할때 모델 여러개를 복합적으로 엮어서 해야한다.
-
Diffusion Model 의 등장
- 최근에는 diffusion model이 강력하면서도 놀라운 생성능력을 보여줌.
-
Controlling Generative model.
- Controlnet 및 다양한 통제 기법들 소개하면서 controlnet 장단점 자세히 설명
- 하지만 controlnet도 모델 구조상 Image-based VITON task에 적합하진 않다.
- Text driven 이기 때문에 input 이 image 가 아닌 noise 이다. Noise 에서 시작함
- 심지어 text 는 해당 task 에 필요가 없다.
- Input 에 noise 하나만 들어가서 (적어도, cloth-agnoistic image 가 같이 들어가야 된다) target person 의 정보를 줄 수 없으니 target person 자체를 정의할 수도 없고 보존할 수도 없다.
\(\textbf{We Want}\)
- 적은 데이터셋에도 학습이 잘 되는 모델 \(\rightarrow\) trainable parameter 가 적은 model
- 배경이 복잡해도 작동하는 model
- 상하의 다 적용가능할 뿐만 아니라, full body 여도 처리가능한 모델
- 사람/옷의 detail (시계, 문신, 옷 색깔 조합 등) 이 보존되는 모델
- target person detail 의 손실 발생 원인: agnostic-v3.2 가 상반신을 다 덮어서 시계나 문신이 가려지기 때문이다.
- 이 경우, inference 때에는 해당 부분에는 mask 를 칠하지 않고 진행?
\(\textbf{Solution}\)
-
Method
- Zero-Kernel: image-encoder 도 person info 를 받을때에는 해당 부분을 그대로 이용하면 된다.
- Condition
-
- cloth
-
- agnostic_mask: 왜 필요하지
- agnoistic_mask 만 다운 샘플링해서 들어간다.
-
- image-densepose: pose, shape info of target person
-
- agnostic-v3.2: target clothing region 을 제외한 나머지 정보 제공 (e.g., 배경, 바지에 대한 모든 정보, 얼굴, etc.)
-
- Canny edge: 원본을 보존할 순 없고, 형태를 보존한다.
- Canny edge 는 target person info 보단, target person cloth info 를 더 많이 제공을 한다. Train 시에는 target person cloth 와 cloth 가 같아서 상관 없겠지만, test 에는 target person cloth 와 cloth 가 달라서 잘못된 정보를 받을 가능성이 있다. 따라서 image-densepose 가 적합하다.
-
- Cloth mask: clothing 에 white region 이 많다면 model 은 해당 부분이 옷의 일부분인지 배경인지 구분하기 어렵다.
- Binary mask 여서 channel 이 \(1\) 이다. 근데 채널이 \(1\) 이면, Encoder 에 넣을 수 없어서 channel \(3\) 으로 확장시켰다.
-
- Implicit Warping: person info 가 들어가야 한다.
- Image-encoder: ControlNet 구조를 사용하면 CLIP image encoder 를 사용해서 condition 으로 받을 수 있어야 한다.
- 어떤 image 를 ControlNet 에 줄까
- 어떤 image 를 CLIP image encoder 에 줄까
- 어떤 image 를 ControlNet 과 CLIP image encoder 에 concat 할까
- CLIP image encoder 의 경우, self-referencing 을 걱정하지 않아도 된다. 즉, 정보 병목 현상을 제거해도 된다. ([CLS] token 만 사용하는 것이 아닌, 모든 token 을 사용해도 됨)
-
- Paint-by-Example 과는 달리 input 과 reference 가 완전 동일하지 않다.
-
- 일반적으로 clothing 을 warp 해야 하니, 복사 및 붙여넣기가 안된다.
- 다음과 같이 진행하면, 옷의 대한 정보를 더 잘 추출할 수 있다.
-
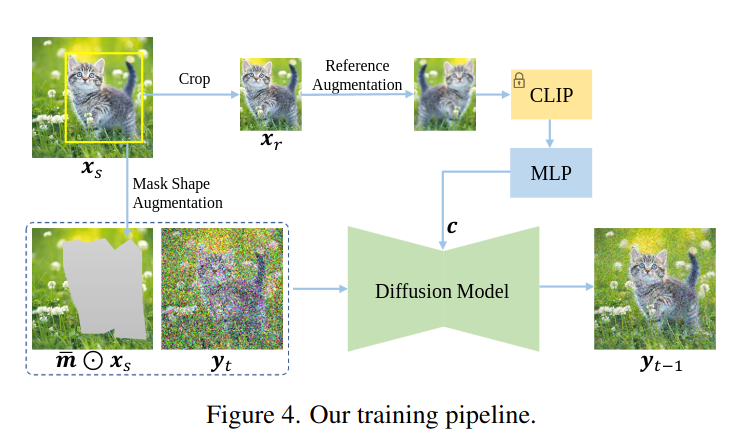
- Augmentation: Paint-by-Example 과 달리 self-referencing 이 아니여서 strong augmentation 이 아닌 rotation/flip 과 같은 간단한 거를 사용해도 된다. (in Diffuse to Choose)
-
Component.
-
- Controlnet.
- ControlNet 은 입력 제어 맵에서 내용을 인식하는 능력이 강력하다. 즉 강력한 인식 능력을 가지고 있어서 어려운 조건 (e.g., image 가 불명확한 것처럼 정보가 부족한 상황)에서도 잘 작동한다.
- 사실 다른 인코더도 사용할 수 있지만, 목표에 따라 다르다. 즉, 제한 조건이 많은 해당 task 의 경우 강력한 인코더가 필요하다.
- 관련 실험
- Controlnet 은 SD model 을 copy 하는 거여서 어쨌든 condtion 이 들어가야 한다. 즉, ControlNet 을 사용하려면 ControlNet 말고도 condition 은 무조건 존재해야된다.
-
- Image-Encoder (CLIP-Image or DINOv2 encoder/ControlNet)
- ControlNet (prompt-based) 은 Image-based VITON 에 적합한 구조는 아니다. \(\rightarrow\) 하지만 이 구조 자체가 robust architecture 인 것은 맞음.
- CLIP-Image encoder 는 \(224 \times 224\) 라 resolution 에 맞는 detail condition 을 뽑기가 어렵다.
- Pre-trained CLIP-Image encoder 는 입력을 \(224 \times 224\) 로만 받는다.
- CLIP 은 text-image alignment 를 향상시키게끔 학습되었고, 우리의 task 는 text 와는 연관이 없으니 오히려 DINOv2 가 낫다.
- DINOv2 image encoder 는 input resolution 을 patch size ( \(14\) ) 로 나눌 수 있으면 제한 없이 받을 수 있다. 학습된 데이터 양 ( \(400\) M(CLIP) vs \(142\) M)은 적지만, parameter CLIP 보다 많고 ImageNet dataset 으로 학습했기 때문에 (realistic style) fashion domain 에서도 적합하다.
- 내가 \(512 \times 384\) resolution 을 사용한다면 DINOv2 input 으론 \(518 \times 392\) 또는, \(518 \times 378\) 이 들어가야 한다.
- CLIP image encoder 보다 parameter 가 많다.
- \(427,616,512\) (CLIP) vs \(1,136,480,768\)
- DINOv2 를 사용하는 경우, DINO 는 self-supervised learning 으로 학습되었으니 굳이 backbone 을 학습시키지 않고 projector 부분만 학습을 진행해도 된다. (또는, backbone 에서의 attention 부분만)
- Diffuse to Choose 의 논문에서도 DINOv2 를 사용했다.
- \(224 \times 224 \times 3\) 의 input image 를 통해 [CLS] + patch token 을 사용하여 \((256 + 1) \times 1536\) 의 output dimension 을 image embedding 으로써 사용했다.
- 하지만, DINOv2 논문의 Sec.4 Adapting the resolution 와 Appendix B.2 에서 언급했듯이 \(224 \times 224\) 로 학습하고 \(10\) K 만큼 \(512 \times 512\) 학습했기 때문에 \(512 \times 384\) 에도 잘 작동할 것이다.
- Ref. Issue
- DINOv2 Visualization: Ref. Issue, Ref. Issue 2
-
- Zero-Kernel
- 입력을 줄 때, noise 뿐만 아니라 다른 정보들도 concat 을 하는데 이때 이 정보들을 짧게 처리해서 넣어주는 건 정보를 온전히 받아들일 수 없다. \(\rightarrow\) Zero-Kernel
- 예시로, Stable-VITON 의 경우 initial conv 로 concat 한 정보들을 처리해서 SD Encoder 로 넣어주려면 \(4\) channel 로 압축해야하는데 이는 정보 손실이 일어나는 구간 (병목현상)으로 볼 수 있고, 게다가 SD Encoder network 는 freeze 라 concat 한 새로운 정보를 제대로 받지 못할 수 있다. 즉, Condition의 정보를 제대로 흡수해야한다
- ControlNet 과 SD Encoder 의 zero kernel 수는 다르다.
-
- Decoupled-condition
- ControlNet 에는 target person info, SD 에는 clothing info 를 준다.
- 즉, cloth agnostic mask (clothing region 이 masking 된) 와 clothing image 가 입력
- 이로써 얻을 수 있는 이점은 다음과 같다
- 추가적인 정보를 전달해, Warping process 를 강화시킬 수 있다.
- SD encoder 에 기본적인 옷의 정보를 전달하여 시작할 수 있다.
- Patch 별로 정보를 전달 할 수 있다.
-
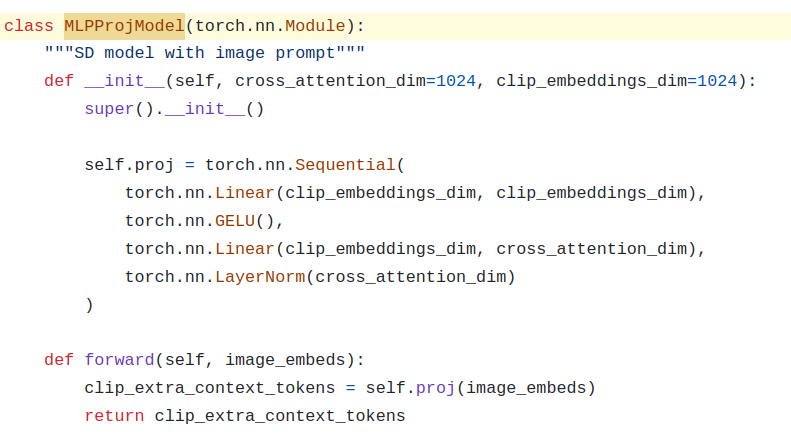
- Image encoder \(\rightarrow\) MLP
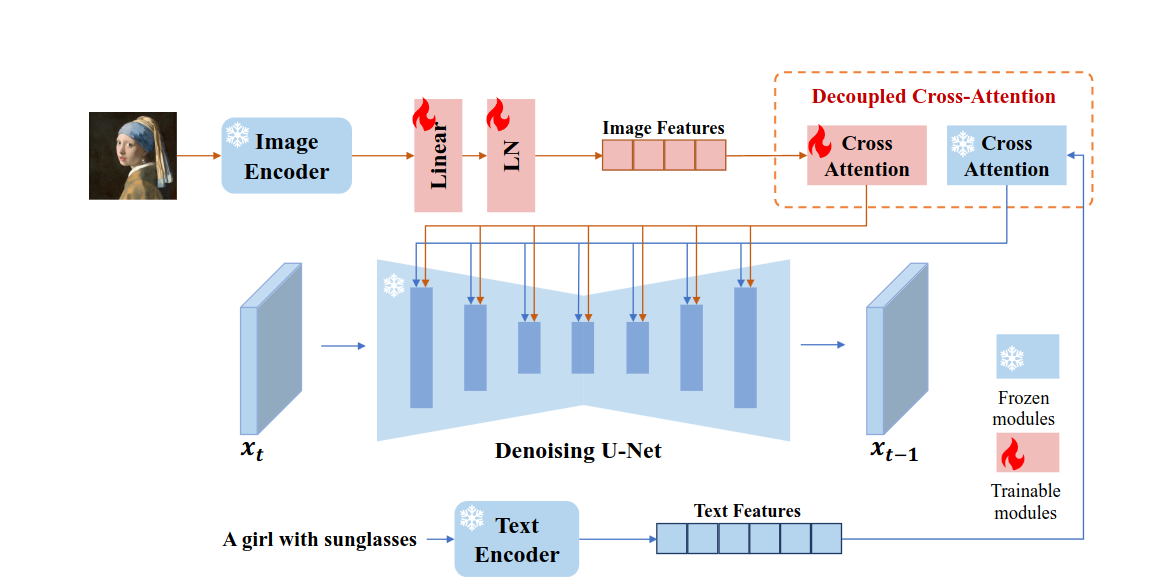
- IP-Adapter 에선 \(2\) 개의 linear layer 와 GELU layer Norm 을 사용했다.
- Paint by example 에선, linear layer \(1024 \rightarrow 768\) 짜리 하나
-
- Classifier-free Guidance
- Uncond 가 적용되는 건 지금, Image encoder 에서만이다. 즉, uncond 가 적용되면 ControlNet 과 SD 에 condition 으로 zero 가 들어간다.
-
- Augmentation
- Simple augmentation: flip, rotation, etc.
-
-
Training Approach:
- Fine-tuning vs Parameter-efficient
- Use LoRA
- Freeze U-Net vs Unfreeze
- Out-of-Distribution data 가 들어오면 U-Net 은 생성 능력이 떨어진다. 따라서 U-Net 도 학습은 해줘야 한다.
- Train Cross-attention/Self-attention
- Existing SD model 은 text-encoder 에 대해서 학습되었다. 즉, 적어도 cross attention 은 학습해야 하고자하는 task 에 맞춰서 domain shift 가 될 것이다.
- Ref. IP-Adapter: text encoder \(\rightarrow\) image encoder 로 바꿈으로써 cross-attention 학습
- Self-attention: 마찬가지로 학습 data 가 fashion image 이므로 fashion domain 에 맞게 학습해야 한다.
- Ref. prompt-to-prompt: spatial layout and geometric 이 cross-attention 에 의존한다.
- Ref. Textual Inversion: text embedding 만 학습하기 때문에, text embeding 을 아무리 최적화 시켜도 diffusion model 이 학습한 distribution 에 없으면 생성하기가 힘들다. 따라서 diffusion model 도 어떤 방식으로든 학습시켜야한다.
- Existing SD model 은 text-encoder 에 대해서 학습되었다. 즉, 적어도 cross attention 은 학습해야 하고자하는 task 에 맞춰서 domain shift 가 될 것이다.
- Fine-tuning vs Parameter-efficient
-
Additional method
-
- Loss function: Total Variation Loss, Perceptual Loss etc.
-
-
Tip
- One-stage 로 하려면 결국 warped cloth image information 을 implicit 하게 학습해야 한다. 그러기 위해선 사람 이미지 정보를 줘야 한다.
- E.g., StableVITON: ControlNet input 에 사람 정보 더해주기
- Image 장 수가 적으니까 trainable parameter 가 많으면 안된다.
- One-stage 로 하려면 결국 warped cloth image information 을 implicit 하게 학습해야 한다. 그러기 위해선 사람 이미지 정보를 줘야 한다.
\(\textbf{Final Method}\)
- (?)
\(\textbf{First Experiment}\)
-
Stable diffusion model v1.5 + CLIP image encoder + Zero-kernel + classifier-free guidance
-
Augmentation, target person info
-
vs full fine-tuning
고려 사항
- Uncond probability: \(0.1\) / \(0.2\)
\(\textbf{Therefore}\)
- Robust (augmentation, 모델 구조 개선을 통한 확실한 정보 흡수)
- Reasonable (method 전개)
- Generalization (상하의 가능, 복잡한 배경, 풀바디)
- Parameter efficient fine-tuning
- Clothing detail 과 target person detail (e.g., 시계, 문신 등)
\(\textbf{Reference Architecture}\)
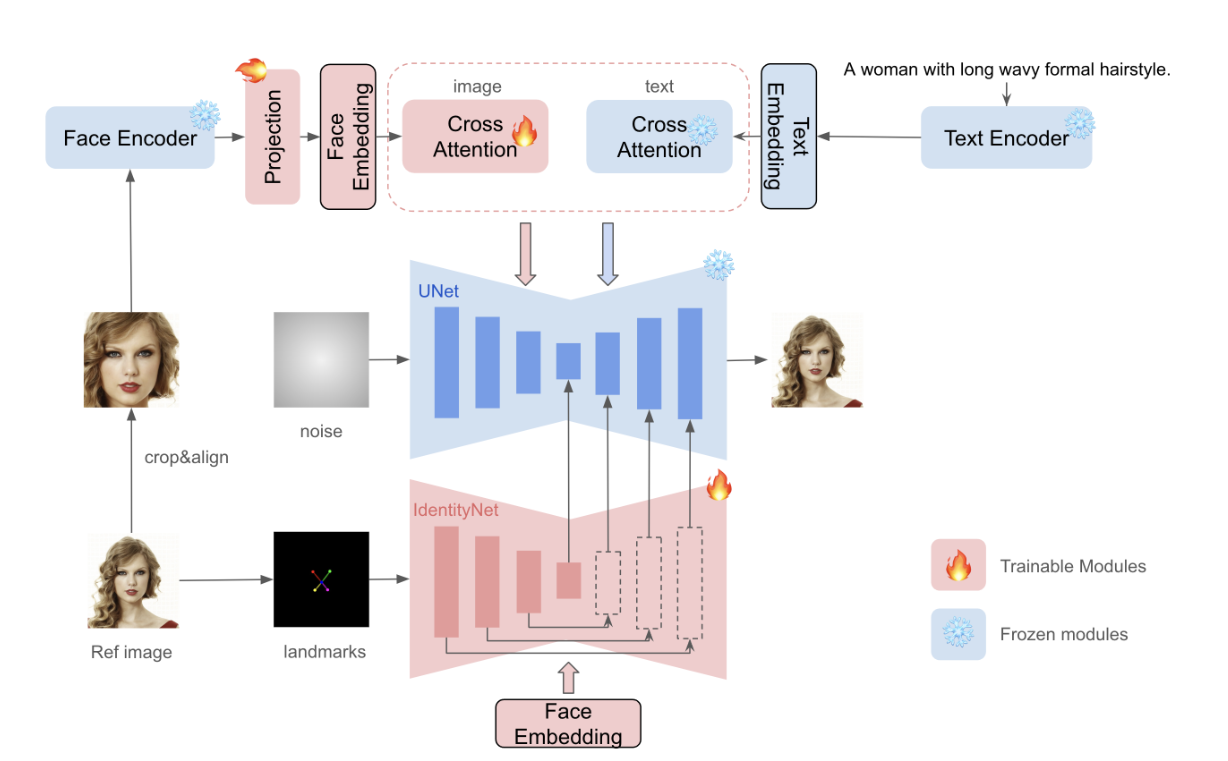
- Instant ID
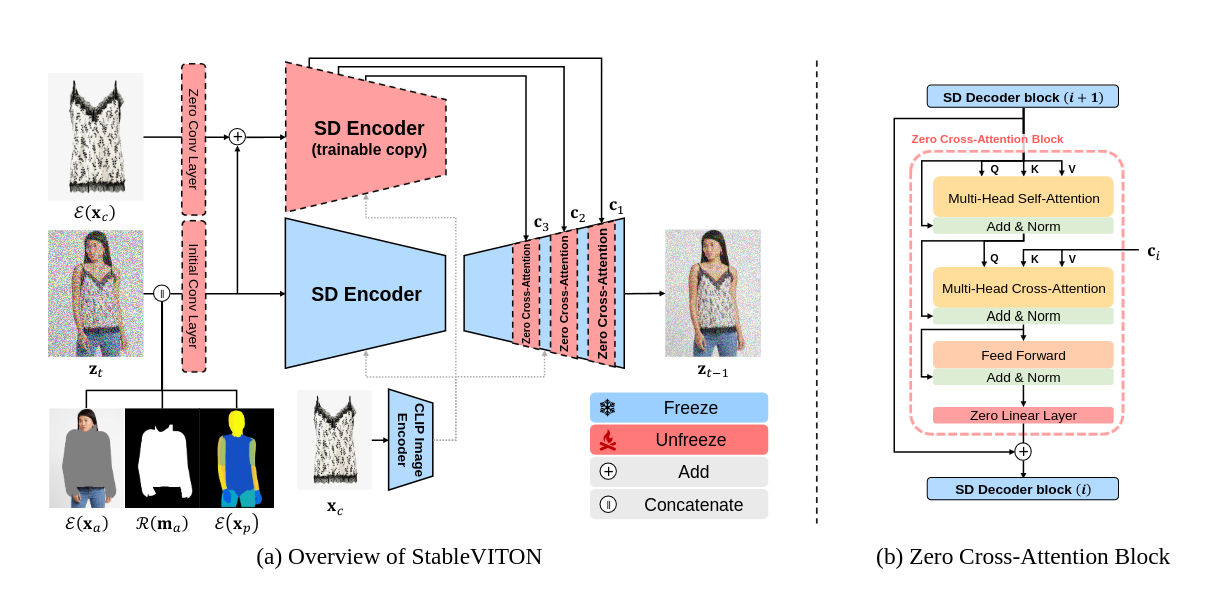
- StableVITON
- Warping clothing 을 만들기 위해 ControlNet input 에 person info 를 concat 한다.
- IP-Adapter
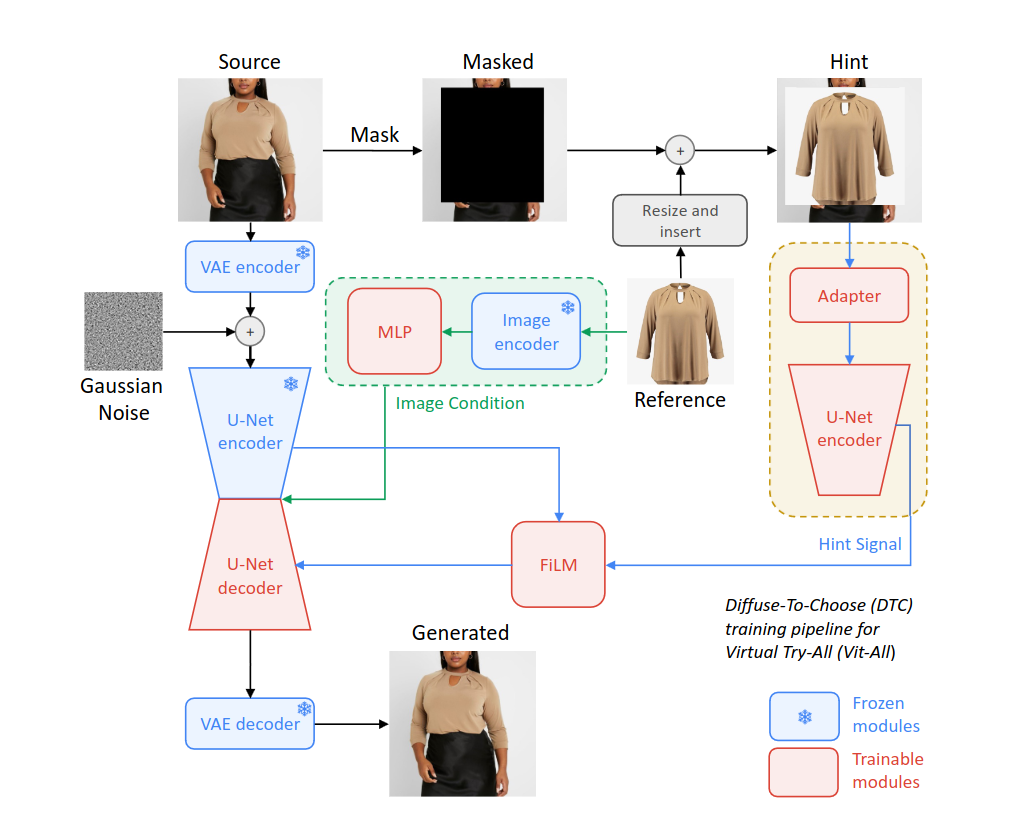
- Diffuse to Choose paper
- Warping clothing 을 만들기 위해 pixel-level 의 hint 를 제공한다.
- Paint-by-Example
\(\textbf{Question}\)
- Condition info 는 성능 향상에 도움이 되고 guide 하기 좋다. 하지만 너무 많은 condition 은 제약이 있다는 말과 동일하여 실제 환경에서는 사용하기 어려울 수 있다. Condition 이 얼마나 잘 주어지냐에 따라 성능 변동 요인이 많아질수도 있다.
- Generative model 의 성능이 올라갔다면, 그에 따라 condition 을 real env 에 맞게 간편하게 바꿀 필요가 있지 않을까?
- FP \(32\) 로 train/test 하면 성능이 올라가는가?
- 일단 inference 때, \(32\) 로 하면 성능이 올라가는 것 처럼 보였다.
- Inference 때, 이미지가 흐리게 나왔던 이유는 Diffusion model 의 Encdoer weights 를 ControlNet 에 옮겨주지 않았기 때문이다. (LoRA weight 만 옮기고 나머지는 randomly initialize 였다)
- ControlNet 구조에서의 Zero-Conv
- Zero-Conv 의 목적은 기존의 SD 의 능력을 유지하려고 하는건데
- 해당 조건을 만족시키기 위해서는 MLP 에서의 condition 을 줄 때 cross-attetion 안에서도 zero-linear 를 추가하여 unconditional diffusion model 처럼 작동시켜야 한다.
- 여기서 두 갈래로 나눠질 수 있는데, 초기에 unconditional diffusion model 처럼 만들건지 / 그냥 초기 output 이 망가지더라도 zero 를 사용하지 않을 건지이다.
- uncoditional model: 초기 output 을 잘 만들어서 loss 방향을 잘 잡자
- 그냥: 어차피 domain 자체는 다른 ControlNet 예제처럼 canny edge 나 segmenation map 처럼 다른 domain 이 아닌 cloth 처럼 realistic image 가 들어간다. (이때 다른 condition 은 zero-kernel 로 인해 정보가 안들어가니 상관없다)
- 오히려, zero-conv 를 앞단에 두는 느낌?
- 사람은 그대로 생성해야 하니, data augmentation 을 진행하지 않는다. 따라서 사람에 관련된 condition 은 놔둔다. 옷에 대한 것만 augmentation 을 진행할건데
- cloth mask 에 대해서도 augmentation 을 적용?
- cloth mask 에 대해서 cloth 와 동일한 augmentation 을 적용?
- 적용하되, 같은 augmentation 을 적용한다. 경계선을 지어주려고 mask 를 넣는건데 다른 augmentation 이면 효과가 없을 거 같다.
- Dinov2 에 입력으로 들어가는 cloth 에도 augmentation 을 적용?
- ControlNet 에서 augmentation 을 하는 건 warping module 의 향상성을 위해서 하는거다.
- 하지만 Dinov2 에서 augmentation 을 안한다고 해서 train/test mismatch 가 발생하는 것도 아니기 때문에 이건 굳이 안해도 될거같다.
- Blur augmentation 사용?
- 기대효과: super resolution? 좀 더 선명하게 생성해라. 그러기 위해선 데이터 정보를 더 잘 빼야겠지
- 근데 오히려 global info 만 뽑을 거 같아서 하지 않는다.
- cloth mask 에 대해서도 augmentation 을 적용?
- 얼굴을 잘 못그리는데, 이건 왜 그럴까에 대해 \(2\) 가지로 나눠봤다.
-
- SD 의 한계: 사람 얼굴 그리기가 어려운데 full-body 여서 얼굴이 작아서 더 못그린다.
-
- Full-finetuning 을 하지 않아서
-
- person 에 맞춰진 cloth mask 를 주지 않아서? masking region 만 그리면 되는데 이 기준을 주지 않아서 모델이 전부 그리는 느낌?
- 왜냐면, 배경에 대해서도 완벽하게 동일하지 않다. (바지나, 뒤에 색상)
-
Introduction
- online-shopping
- 이 시장에 대한 얘기, 중요성 강조
- VITON
- difficulty
- 간단한 다른 연구들의 소개
- 다른 연구들의 한계
- 우리가 해결하고자 하는 것과 이들과의 다른 점
- Our Contribution
Related Work
VITON paper 의 다른 related work 를 보고 추가하자
-
DreamPaint: Dreambooth 를 이용하여 text token 에 subject 를 binding 시키고 inpainting model 을 이용하여 Virtual try-on 을 하는 method 를 제안했다.
- Item 의 detail 을 잘 보존하지만 real-time application 에 최적화되어있지 않다.
-
Paint by Example 은 zero-shot setting 에서 작동하며 in-the-wild image 도 처리할 수 있다. 그러나 reference image 의 [CLS] token 만을 활용하는 conditioning process 에서 information bottleneck 이 발생합니다.
- 이 제약으로 인해, reference image 의 일반화가 지나치게 이루어지며, 필수적인 세밀한 세부 정보를 유지할 수 있는 모델의 능력이 저하됩니다.
-
VITON: Two-step (synthesis and refinement process), 초기에 생성된 coarse image 와 desired clothing 을 이용하여 detaile 을 강화시키기 위해 refine 한다.
- VITON-HD: higher-resolution image 에 초점을 맞췄고 misaligned parts 를 정렬시키기 위해 alignment-aware segment normaliaation 를 사용한다.
- TryOnGAN: pose conditioning 을 사용하지만 purely latent model 에 의존하여 의류를 표현할 때 종종 세세한 세부 사항이 부족하다.
- TryOnDiffusion: pixel-level diffusion model 에 dual U-Net 으로 접근했다. 가상 시착에 대해서는 인상적인 성능을 제공하지만 in-the-wild example 에는 어려움을 겪고있다. 상의만 지원하며, 실시간 사용에 적합하지 않다.
- 실제 사용 사례에서 실시간 추론을 보장하기 위해서는 latent diffusion approach 가 필요하다.
-
Diffuse to Choose
- Pose conditioning 을 도입하여 이를 완화할 수 있지만, 본 논문은 virtual try-all 이기 때문에 더 넓은 적용 가능성을 위해 task-specific auxiliary input 보다 일반적인 목적을 우선시했다.
- 더 큰 image encoder 사용 (모든 token 사용)
- Perceptual loss 사용
- Hint signal: reference image 로부터 pixel-level 의 세밀한 세부 정보를 main U-Net 으로 전달
-
Image Encoder
- DINOv2 vs CLIP encoder
- Generative models
- Diffusion