PASD: Pixel-Aware Stable Diffusion for Realistic Image Super-Resolution and Personalized Stylization
ECCV(2024), 34 citation, The Hong Kong Polytechnic University & Alibaba Group, Review Data: 2024.08.20
한 줄 요약
Pre-trained Stable Diffusion에 pixel-aware cross attention, degradation removal module, adjustable noise schedule을 더해, 픽셀 단위 구조를 유지하는 Real-ISR과 paired data 없는 personalized stylization을 하나의 framework로 수행한다.
| 흐름 | 내용 |
|---|---|
| 문제 | GAN 기반 Real-ISR은 현실적 디테일 재현에 한계가 있고 artifact가 생기며, ControlNet 등 SD prior 활용 방법은 신뢰성 있는 pixel-wise image structure를 유지하지 못한다 |
| 아이디어 | PACA로 diffusion model이 픽셀 단위로 지역 구조를 인식하게 하고, degradation removal module로 열화에 둔감한 multi-scale 특징을 추출하며, ANS로 LQ latent에 추가 noise를 더해 train-test discrepancy를 완화 |
| 결과 | 픽셀 수준 구조를 유지한 현실적인 super-resolution과, base model을 stylized/미적 모델로 교체하는 것만으로 다양한 스타일 생성 및 오래된 사진 복원, LQ 잔여 신호 조절로 perception-fidelity trade-off 조절 |
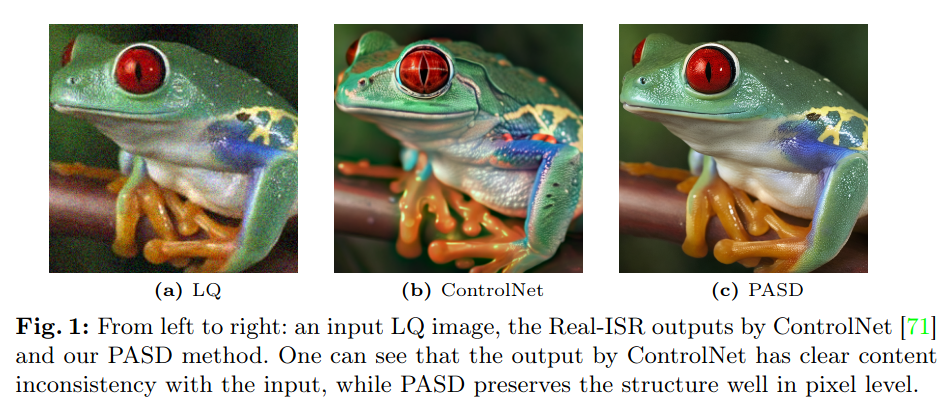
Figure 1. PASD 결과 예시
1. 문제 정의 — 왜 이 논문이 필요한가
배경.
-
실제 세계의 이미지는 획득 과정에서 저해상도, 블러, 노이즈 등 복잡한 열화가 혼합되어 발생하는 경우가 많다. 이미지 복원 방법은 특히 딥러닝 시대에 큰 진전을 이루었지만, 여전히 방법론 설계에서 이미지 충실도를 추구하다 보니 과도하게 부드러운 디테일을 생성하는 경향이 있다. 이미지 충실도에 대한 제약을 완화함으로써 현실감 있는 이미지 초해상도(Real-ISR)는 열화된 관찰 데이터로부터 지각적으로 현실적인 이미지 디테일을 재현하는 것을 목표로 한다. 생성적 적대 신경망(GAN)과 적대적 학습 전략은 Real-ISR에서 널리 사용되었고, 유망한 결과를 얻었지만, GAN 기반 Real-ISR 방법은 여전히 풍부하고 현실적인 이미지 디테일을 재현하는 데 한계가 있으며, 종종 불쾌한 시각적 인공물을 생성하는 경향이 있다.
-
Diffusion model은 다양한 image 생성, 수정, 향상, 전이 task들에 대해서 인상적인 성능을 보여줬다. 특히, pre-trained text-to-image stable diffusion model은 strong generative priors를 가지고 realistic super-resolution (Real-ISR)와 image stylization problem에 대해서 잠재적인 해결책을 제공했다.
기존 방법의 한계.
-
GAN 기반 방법은 만화화 및 오래된 사진 복원과 같은 다양한 이미지 스타일화 작업에서도 널리 사용되어 왔다. 예를 들어, Chen 등은 CartoonGAN을 제안하여 짝을 이루지 않은 데이터를 사용해 만화 스타일화를 생성했다. 그러나 서로 다른 스타일을 위해서는 다른 모델을 훈련시켜야 했습니다. Wan 등은 삼중 영역 변환 네트워크를 도입하여 오래된 사진을 복원했으나, 이 방법의 다단계 절차는 사용하기에 복잡하다는 단점이 있다.
-
하지만, 기존의 방법론들은 신뢰성있는 pixel-wise image structure을 유지하는 데 실패했다.
-
ControlNet은 픽셀 단위의 조건부 제어에는 적합하지 않다. Liu와 Wang 등은 사전 학습된 SD 프라이어를 이미지 컬러화 및 Real-ISR에 사용할 수 있음을 입증했으나, 픽셀 수준의 세부 정보를 전달하기 위해 스킵 연결에 의존하여 이미지 복원에 추가적인 학습이 필요했고, 이는 이미지 스타일화와 같은 잠재 공간에서 수행되는 작업에 모델의 능력을 제한했다.
이 논문의 접근.
- 본 연구에서는 Real-ISR 및 개인화된 이미지 스타일화를 달성하기 위해 pixel-aware stable diffusion (PASD) network를 제안한다.
- 구체적으로, pixel-aware cross attention module을 도입하여 diffusion model이 픽셀 단위로 이미지의 지역적 구조를 인식할 수 있도록 한다.
- Degradation removal module을 사용하여 이미지의 고수준 정보와 함께 확산 과정을 안내하는 degradation에 민감하지 않은 특징을 추출한다.
- 조정 가능한 noise schedule을 도입하여 이미지 복원 결과를 더욱 향상시킨다.
- Base diffusion model을 stylized diffusion model로 대체하는 것만으로도 PASD는 쌍을 이루는 학습 데이터를 수집하지 않고도 다양한 스타일의 이미지를 생성할 수 있으며, 기본 모델을 미적 모델로 교체함으로써 PASD는 오래된 사진을 되살릴 수 있다.
Word
- PASD: Pixel-Aware Stable Diffusion
- PACA: Pixel-Aware Cross Attention
- Real-ISR: Realistic Image Super-Resolution
- HQ: high-quality image
- LQ: low-quality image
- ANS: Adjustable noise schedule
2. 사전 지식
- Realistic image super-resolution
- Personalized Stylization
- Diffusion Probabilistic Models
3. 방법
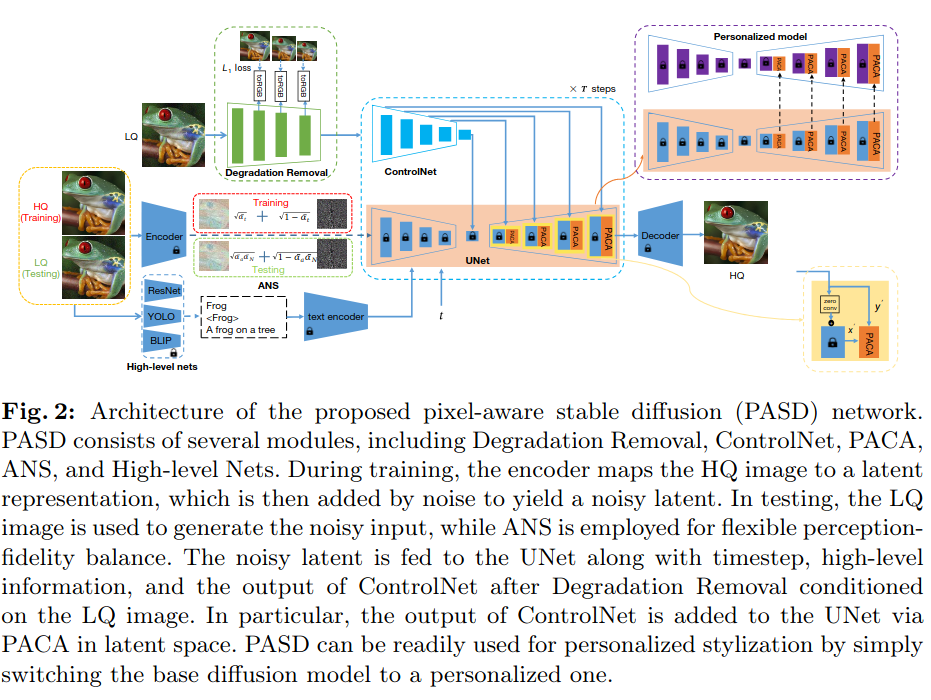
- PASD
- Degradation Removal, ControlNet, PACA, ANS, High-level Nets
- High-level Nets: image를 보고 대략적인 captioning을 진행하는 network
-
Degradation Removal
- 저해상도 이미지의 degradation 영향을 줄이고 저해상도에 민감하지 않은 저수준 제어 특징을 추출한다.
- LQ 이미지에서 깨끗한 특징을 추출하여 확산 과정을 제어한다.
- LQ 이미지의 \(1/2, 1/4, 1/8\) 축척 해상도에서 다중 스케일 특징 맵을 추출한다.
- 직관적으로, 이러한 특징들이 해당 스케일에서 고해상도(HQ) 이미지를 최대한 가깝게 근사할 수 있도록 사용되며, 이후의 확산 모듈이 현실적인 이미지 디테일 복원에 집중할 수 있도록 하여 이미지 열화를 구별하는 부담을 줄인다.
- 따라서, 모든 단일 스케일 특징 맵을 HQ RGB 이미지 공간으로 변환하기 위해 "toRGB"라는 컨볼루션 레이어를 사용하는 중간 감독을 도입한다. 각 해상도 스케일에서 L1 손실을 적용하여 해당 스케일에서 HQ 이미지의 피라미드 분해와 유사하게 재구성되도록 한다.
- 이 module은 Real-ISR task에서만 필요하다.
-
High-level Nets
- 의미적 제어 특징을 추출하는 고수준 정보 추출 모듈
-
Pixel-Aware Cross Attention (PACA)
- 이미지 복원 과정에서 이미지 디테일과 texture를 픽셀 단위로 인식시킨다.
- 잘 알려진 ControlNet은 엣지나 분할 마스크와 같은 작업별 조건을 잘 지원하지만, 픽셀 단위의 제어에는 실패한다.
- 두 네트워크의 특징 맵을 단순히 더하는 것은 픽셀 수준의 정밀한 정보를 전달하지 못할 수 있으며, 입력 저해상도(LQ) 이미지와 출력 고해상도(HQ) 이미지 간의 구조적 불일치를 초래할 수 있다. LQ 입력에 ControlNet을 단순 적용했을 때 출력 이미지에서 구조적 불일치가 명확하게 나타난다.
ANS (Adjustable Noise Schedule)
- 이전 연구에서 [1, 2] 언급됐듯이 Stable Diffusion에서 사용하는 noise schedule은 train-test discrepancy가 존재하기 때문이다. 이는 학습 단계에선, 최종 time step에서의 SNR (signal-to-noise)이 0이 되지 않아 잔여 신호가 남아있는 반면 inference에선 pure noise를 사용하기에 문제가 된다. 이 문제를 완화하기 위해 SeeSR [3]은 inference에서 LQ latent를 pure noise에 추가시킨다. 마찬가지로 PASD [4]도 LQ latent를 pure noise에 추가하여 불일치 문제를 해결하고자 했다. 따라서, SR task에서는 low-resolution signal을 제공하므로 early layers가 coarse feature에 크게 얽매이지 않는다.
- SeeSR과 PASD는 같은 저자가 있는데 PASD가 더 최근의 sampling방식을 사용했다.
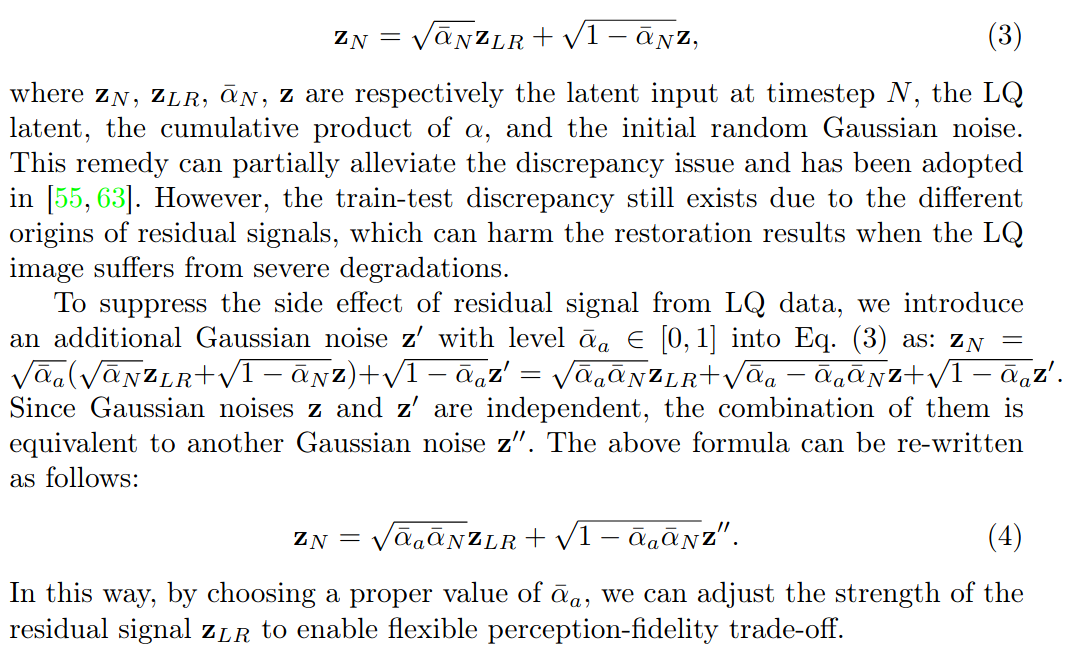
- PASD에서의 sampling 방식은 SeeSR의 개선된 버전이다. SeeSR이 inference시에, 제공한 signal은 LQ이다. 하지만 학습 시에 사용하는 signal은 HQ로, 사실 잔여 신호의 출처가 다르다. (train: HQ signal, inference: LQ signal) 이때, LQ가 심각한 열화를 겪을 때 복원 결과에 악영향을 끼칠 수 있다. 따라서 PASD에서는 LQ 데이터에서 발생하는 잔여 신호의 부작용을 억제하기 위해, 추가 가우시안 잡음을 도입했다. LQ 잔여 신호를 조절함으로써 flexible perception-fidelity trade-off를 맞출 수 있다.
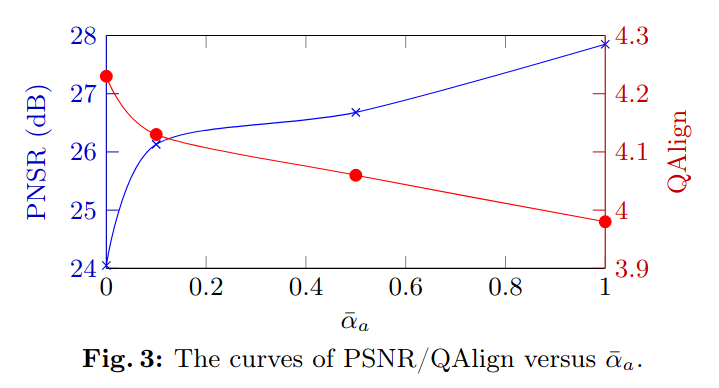
- \(\bar \alpha_a\)는 \(a = t =900\)인 \(0.1189\)를 썼다. Trade-off를 가장 잘 반영하는 값임.
[1] Choi, Jooyoung, et al. "Perception prioritized training of diffusion models." Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition. 2022.
[2] Lin, Shanchuan, et al. "Common diffusion noise schedules and sample steps are flawed." Proceedings of the IEEE/CVF winter conference on applications of computer vision. 2024.
[3] Wu, Rongyuan, et al. "Seesr: Towards semantics-aware real-world image super-resolution." Proceedings of the IEEE/CVF conference on computer vision and pattern recognition. 2024.
[4] Yang, Tao, et al. "Pixel-aware stable diffusion for realistic image super-resolution and personalized stylization." arXiv preprint arXiv:2308.14469 (2023).
4. Code Review
-
실제로 코드에서는 Adjustable Noise Schedule (ANS)가 어떻게 구현됐는지 보자
- 결국 \(T\)에서의 latent를 보면된다.
-
PASD > test_pasd.py
PASD > pasd > pipelines > pipeline_pasd.py > def prepare_latents- LQ image를 latent space로 보내서 \(T\) 시점의 noise를 먼저 더한다.
- 이후,
args.added_noise_level = 900에서의 noise를 더하면 완성이다.
init_latents = self.vae.encode(image*2.0-1.0).latent_dist.sample(generator)
init_latents = self.vae.config.scaling_factor * init_latents
self.scheduler.set_timesteps(args.num_inference_steps, device=device)
timesteps = self.scheduler.timesteps[0:]
latent_timestep = timesteps[:1].repeat(batch_size * 1) # 999 what if <999"?
shape = init_latents.shape
noise = randn_tensor(shape, generator=generator, device=device, dtype=dtype)
init_latents = self.scheduler.add_noise(init_latents, noise, latent_timestep)

added_latent_timestep = torch.LongTensor([args.added_noise_level]).repeat(batch_size * 1).to(self.device)
added_noise = randn_tensor(shape, generator=generator, device=device, dtype=dtype)
init_latents = self.scheduler.add_noise(init_latents, added_noise, added_latent_timestep)

latents = init_latents